

Boosting och bagging i ensemblemetoder
Boosting och bagging är två populära ensemblemetoder inom maskininlärning som används för att förbättra modellers prestanda. Här är vad du behöver veta:
- Bagging minskar variansen genom att träna flera oberoende modeller parallellt på slumpmässiga delmängder av data. Resultaten kombineras, ofta med medelvärde eller majoritetsröstning, vilket gör metoden robust mot brus och extremvärden.
- Boosting minskar bias genom att träna modeller sekventiellt, där varje ny modell fokuserar på fel som tidigare modeller gjort. Det är effektivt för att identifiera komplexa mönster men kan vara känsligt för brus och riskera överanpassning.
Båda metoderna används inom finansiella analyser, med bagging som passar bättre för volatila och brusiga data, medan boosting fungerar bra för att hitta trender i renare dataset. Valet mellan dem beror på datans egenskaper och resurskraven.
Bagging mot Boosting inom maskininlärning | Ensemble-lärande inom maskininlärning | Simplilearn
sbb-itb-e2221a1
Vad är bagging?
Bagging, eller Bootstrap Aggregating, är en ensemblemetod som syftar till att förbättra stabiliteten och precisionen hos maskininlärningsmodeller. Genom att minska variansen och motverka överanpassning blir resultaten mer tillförlitliga. Metoden går ut på att träna flera oberoende modeller parallellt, där varje modell arbetar med en unik version av samma dataset.
Det hela börjar med bootstrap-sampling, en process där man skapar m nya träningsset genom att slumpmässigt välja observationer från originaldatasetet, men med återläggning. Detta innebär att varje bootstrap-sample innehåller ungefär 63,2 % unika observationer, medan resten är dubbletter. På så sätt introduceras variation utan att det krävs ny datainsamling.
När modellerna har tränats, kombineras deras förutsägelser för att skapa ett slutgiltigt resultat. För regression används medelvärdet av modellernas utfall, medan klassificeringsuppgifter avgörs genom majoritetsröstning. Som statistikern Leo Breiman, som introducerade bagging, uttryckte det:
"If perturbing the learning set can cause significant changes in the predictor constructed, then bagging can improve accuracy".
"Om störningar i träningsmängden kan orsaka betydande förändringar i den konstruerade prediktorn, då kan bagging förbättra noggrannheten" [4].
Hur bagging fungerar
Den verkliga styrkan i bagging märks särskilt när den används med instabila modeller. "Instabila" modeller är sådana där små förändringar i träningsdata kan leda till stora skillnader i resultaten. Exempel på dessa är beslutsträd, neurala nätverk och vissa typer av regression. Genom att kombinera flera sådana modeller jämnas extrema förutsägelser ut, vilket leder till mer konsekventa och pålitliga resultat.
En annan fördel är att varje bootstrap-sample är oberoende, vilket gör det möjligt att köra modeller parallellt. Detta är särskilt användbart om man har tillgång till flertrådade processorer eller GPU:er. Den totala tidsåtgången förändras inte mycket, även om fler modeller läggs till, så länge hårdvaran kan hantera belastningen. Nästa del beskriver hur bagging anpassas för att behandla finansiella tidsserier.
Bagging i finansiella tidsserier
Vid analys av finansiella tidsserier krävs ytterligare anpassningar av bagging för att hantera specifika utmaningar som autokorrelation och icke-stationäritet. En vanlig metod är att först transformera data och sedan tillämpa bootstrap-sampling på residualerna. Därefter återläggs trend- och säsongskomponenterna.
Denna metod tar itu med tre typer av osäkerhet som ofta förekommer i tidsserieprognoser: dataosäkerhet, modellsäkerhet och parameterosäkerhet. Forskning visar att den största förbättringen kommer från att hantera modellsäkerhet, det vill säga osäkerheten kring vilken modell som är bäst lämpad för olika versioner av samma tidsserie. Random Forests, en välkänd tillämpning av bagging, används ofta inom bank- och finanssektorn för att förutsäga framtida resultat baserat på historisk data. Metoden är särskilt effektiv för att hantera icke-linjära samband och saknade värden.
Vad är boosting?
Boosting är en metod inom maskininlärning där flera svaga modeller – ofta enkla beslutsträd – kombineras för att skapa en starkare modell. Målet är att förbättra noggrannheten genom att bygga modeller sekventiellt, till skillnad från metoder som bagging där modeller tränas parallellt. I boosting adderas varje ny modell, Fₘ(x), till den tidigare, Fₘ₋₁(x), med syftet att minimera en specifik förlustfunktion.
Det centrala i boosting är att rätta till tidigare misstag. Nya modeller tränas för att fokusera på de svårigheter där tidigare modeller presterat sämre. Exempelvis ökar AdaBoost vikten på felklassificerade data, vilket gör att nästa modell riktar in sig på dessa. Gradient Boosting fungerar annorlunda genom att varje modell förutsäger residualerna (de negativa gradienterna) av förlustfunktionen. Denna metod minskar systematiska fel och är effektiv för att förbättra modeller som annars har svårt att anpassa sig till datan.
För att undvika överanpassning används ofta tekniker som shrinkage, där varje modells bidrag skalas ner med en konstant, vanligtvis ≤ 0,1. Moderna implementationer som XGBoost och LightGBM använder dessutom tekniker som histogrambaserad uppdelning och L2-regularisering för att hantera stora dataset effektivt. Låt oss nu titta närmare på hur denna metod fungerar i praktiken.
Hur boosting fungerar
Boosting bygger på idén om att korrigera fel genom att träna modeller sekventiellt. Efter att den första modellen tränats identifieras de observationer där modellen presterade sämst, och dessa ges högre vikt i nästa träningsomgång. Processen upprepas tills ett förutbestämt antal modeller har skapats eller tills förbättringarna avtar.
Formeln för Gradient Boosting är: Fₘ(x) = Fₘ₋₁(x) + ν hₘ(x), där ν är inlärningshastigheten och hₘ är den svaga modell som anpassats till den negativa gradienten av förlusten. Detta tillvägagångssätt är flexibelt och kan använda vilken differentierbar förlustfunktion som helst.
Boosting följer en inverterad U-kurva: till en början förbättras prestandan med ökad modellkomplexitet, men för hög komplexitet leder till överanpassning. Ett experiment på MNIST-dataset visade att noggrannheten steg från 0,930 till 0,961 innan överanpassning blev ett problem. Därför används ofta early stopping, vilket innebär att träningen stoppas om valideringsförlusten inte förbättras efter ett visst antal iterationer.
Den sekventiella träningen gör dock boosting mer beräkningsintensivt. Om en ensemble innehåller 200 svaga modeller kan boosting kräva upp till 14 gånger mer beräkningstid än bagging, och resursbehovet ökar kvadratiskt med antalet modeller, till skillnad från den linjära ökningen vid bagging. Trots detta är boosting särskilt användbart för komplexa tillämpningar, som inom finansiella tidsserier.
Boosting i finansiella tidsserier
Inom finansiella tidsserier används boosting för att analysera snabba marknadsrörelser. Algoritmer som XGBoost och Gradient Boosting är populära för att förutsäga trender och uppskatta volatilitet. Dessa metoder kan hantera de icke-linjära mönster som ofta förekommer i marknadsdata, där traditionella modeller ofta misslyckas. Gradientbaserade metoder har också förbättrat beräkningar av Value at Risk (VaR) för aktiemarknader.
Boosting är särskilt effektivt för kortsiktiga prognoser, eftersom modellen snabbt kan anpassa sig till nya marknadsförändringar. Detta gör den till ett kraftfullt verktyg för att analysera strukturerad, tabulär data där signalerna kan vara svaga. Implementationer som XGBoost och LightGBM är dessutom optimerade för att hantera stora dataset med tusentals observationer. Histogrambaserad binning gör det möjligt att arbeta snabbare än traditionella metoder, särskilt för dataset med över 10 000 sampel.
Samtidigt är det viktigt att vara försiktig med överanpassning, eftersom finansiella tidsserier ofta innehåller mycket brus. För att minska risken bör man använda små inlärningshastigheter och early stopping, så att modellen fokuserar på mönster i datan istället för att memorera brus.
Boosting vs. Bagging: Huvudsakliga skillnader
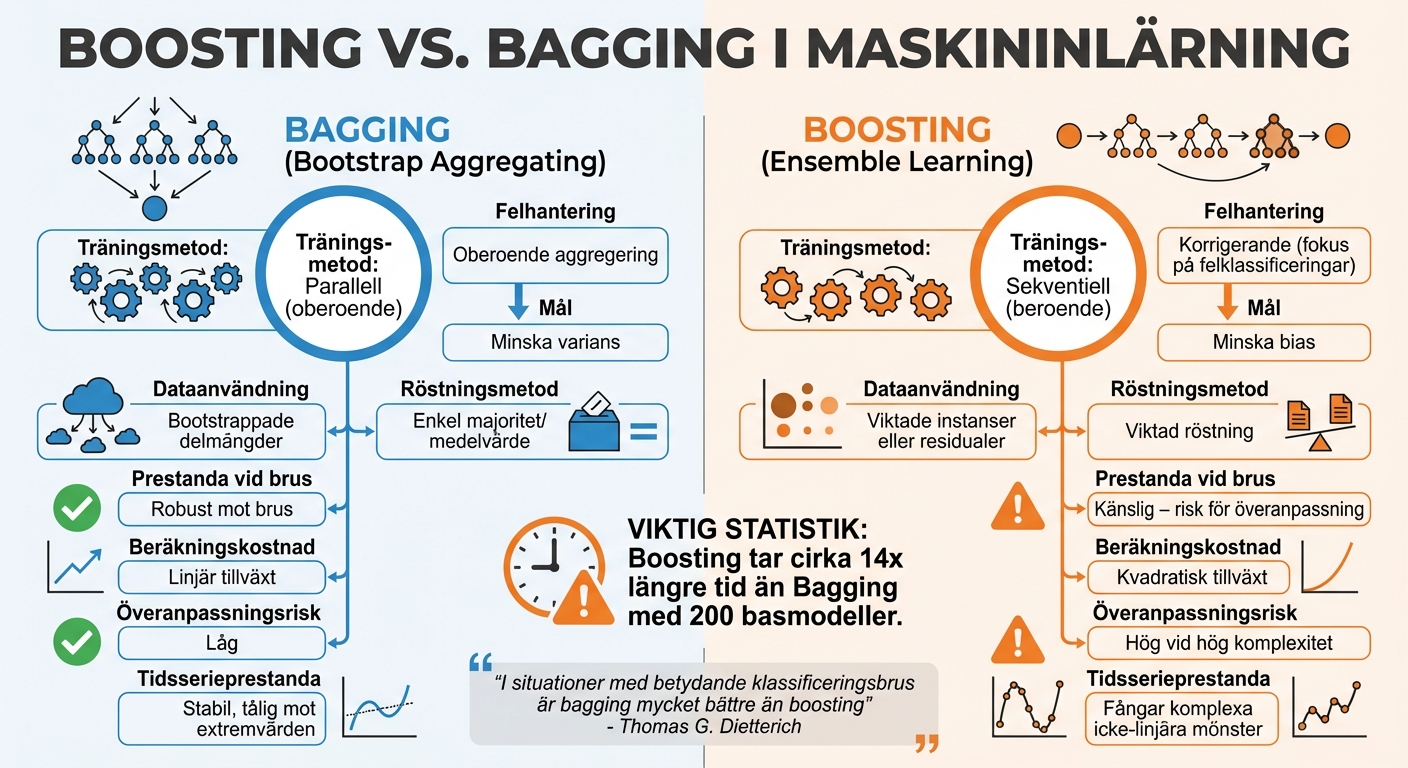
Boosting vs Bagging: Jämförelse av ensemblemetoder i maskininlärning
Boosting och bagging skiljer sig åt i hur de tränar modeller och hanterar fel. Bagging arbetar med parallella och oberoende modeller, medan boosting bygger modeller sekventiellt, där varje ny modell försöker rätta till de misstag som tidigare modeller gjort. Detta påverkar både resultat och resursåtgång.
När det gäller felhantering använder bagging en metod där resultaten från flera modeller kombineras, till exempel genom medelvärde eller majoritetsröstning. Boosting å andra sidan fokuserar på att successivt förbättra tidigare misstag. Bagging minskar därmed variansen och motverkar överanpassning, medan boosting är mer inriktat på att minska systematiska fel (bias).
Träning och felhantering
Bagging tränar sina modeller parallellt, vilket innebär att beräkningstiden inte ökar nämnvärt med antalet modeller. Boosting, som tränar modellerna sekventiellt, kräver däremot mer tid och resurser ju fler modeller som läggs till. Ett experiment på MNIST-datasetet visade att boosting tog ungefär 14 gånger längre tid än bagging när 200 basmodeller användes.
Ett annat område där metoderna skiljer sig är hur de hanterar brus i datan. Bagging är ofta bättre på att hantera brus och extremvärden tack vare att modellerna är oberoende av varandra. Boosting, däremot, kan bli överdrivet fokuserat på svårklassificerade, brusiga data, vilket ökar risken för överanpassning.
"In situations with substantial classification noise, bagging is much better than boosting, and sometimes better than randomization." – Thomas G. Dietterich, Oregon State University
"I situationer med betydande klassificeringsbrus är bagging mycket bättre än boosting, och ibland bättre än randomisering." – Thomas G. Dietterich, Oregon State University [8]
Dessa egenskaper gör att valet mellan boosting och bagging blir särskilt viktigt vid tidsserieprognoser.
Jämförelsetabell: Boosting vs. Bagging
| Aspekt | Bagging | Boosting |
|---|---|---|
| Träningsmetod | Parallell (oberoende) | Sekventiell (beroende) |
| Felhantering | Oberoende aggregering | Korrigerande (fokus på felklassificeringar) |
| Mål | Minska varians | Minska bias |
| Dataanvändning | Bootstrappade delmängder | Viktade instanser eller residualer |
| Röstningsmetod | Enkel majoritet/medelvärde | Viktad röstning |
| Prestanda vid brus | Robust mot brus | Känslig – risk för överanpassning |
| Beräkningskostnad | Linjär tillväxt | Kvadratisk tillväxt |
| Överanpassningsrisk | Låg | Hög vid hög komplexitet |
| Tidsserieprestanda | Stabil, tålig mot extremvärden | Fångar komplexa icke-linjära mönster |
Tabellen sammanfattar de viktigaste skillnaderna och hjälper till att avgöra vilken metod som passar bäst för olika typer av problem.
Prestandan för de två metoderna följer också olika mönster. Bagging har en stadigt ökande noggrannhet som till slut planar ut, medan boosting ofta når en topp och sedan kan tappa i noggrannhet på grund av överanpassning.
Användning av boosting och bagging för tidsserieprognoser
Nu när vi har gått igenom grunderna för bagging och boosting i finansiella tidsserier, låt oss titta närmare på hur dessa metoder används i praktiken för tidsserieprognoser. På finansiella marknader är valet mellan dessa tekniker mycket viktigt, eftersom de är anpassade för olika typer av analyser. Bagging används ofta för att hantera volatilitet och minska risken för felaktiga signaler i brusiga marknadsdata. Å andra sidan är boosting idealiskt för att identifiera komplexa trendmönster och förbättra noggrannheten i prognoser, särskilt när datan är relativt ren och av hög kvalitet.
En studie från maj 2025, utförd av forskaren Aqib Gul, analyserade ensemblemetoder med data från META-aktien mellan 2018 och 2024. Studien visade att enbart boosting hade ett betydligt högre Mean Squared Error (MSE) på 829,16 jämfört med bagging, som uppnådde ett MSE på 413,26. Boostings känslighet för volatilitet förklarar den högre felmarginalen. En hybridmodell som kombinerade båda teknikerna lyckades däremot nå ett betydligt lägre MSE på 41,92.
Styrkor och svagheter i tidsserier
Bagging är särskilt användbart för volatilitetsprognoser och riskhantering, exempelvis vid beräkning av Value at Risk (VaR). Metoden är robust mot extremvärden och plötsliga marknadsskiftningar, vilket gör den till ett pålitligt verktyg i osäkra marknadsmiljöer. Däremot kan bagging vara för försiktig i trendföljande strategier, som momentum och breakout, eftersom den tenderar att jämna ut signaler och därmed missa viktiga rörelser.
Boosting, å andra sidan, är effektivt för att upptäcka komplexa och icke-linjära mönster samt snabba trendskiften. Genom sin iterativa process kan metoden korrigera systematiska fel och upptäcka tidiga signaler i momentumstrategier. Men i marknader med mycket brus kan boosting lätt överanpassa sig till tillfälliga variationer, vilket minskar dess förutsägbarhet. För att undvika detta används tekniker som early stopping och specialiserade förlustfunktioner som ’Huber’ eller ’absolute_error’, vilka gör modellen mindre känslig för extremvärden.
Jämförelsetabell: För- och nackdelar
| Metod | Fördelar | Nackdelar |
|---|---|---|
| Bagging | Minskar varians; robust mot brus och extremvärden; snabb parallell träning; stabil i volatila marknader | Begränsad förmåga att minska bias; kan missa komplexa trender; försiktig i signalhantering |
| Boosting | Hög noggrannhet; upptäcker icke-linjära samband; effektiv för momentumstrategier; kan använda specialanpassade förlustfunktioner | Känslig för brus; risk för överanpassning; långsammare beräkning; sekventiell träning begränsar skalbarhet |
Dessa jämförelser visar hur plattformar som Trendtrading.se använder ensemblemetoder för att förbättra traders strategier. Med hjälp av dessa tekniker optimerar plattformen både manuella och automatiserade strategier genom AI-drivna momentummodeller och verktyg för riskhantering.
Hur man väljer mellan boosting och bagging
Att förstå skillnaderna mellan bagging och boosting är avgörande när du ska välja rätt metod för dina prognosbehov. Denna jämförelse hjälper dig att fatta ett informerat beslut baserat på dina datas egenskaper och dina mål.
Urvalskriterier
Vilken metod som passar bäst beror på datasetets struktur och vad du vill uppnå. Om du arbetar med brusiga finansiella tidsserier fyllda med extremvärden och plötsliga förändringar, är bagging oftast det bättre valet. Denna metod är särskilt bra på att hantera brus genom att minska variansen via medelvärdesberäkning av flera oberoende modeller. Å andra sidan, om du har renare data och använder svaga modeller som lider av hög bias – till exempel grunda beslutsträd – kan boosting ge bättre resultat genom att stegvis korrigera fel och förbättra precisionen.
En annan viktig faktor är beräkningseffektivitet. Boosting kräver mer tid och resurser än bagging, särskilt när ensemblekomplexiteten ökar. Bagging kan köras parallellt, vilket gör det snabbare, medan boosting kräver sekventiell bearbetning, vilket ökar tidsåtgången och resursförbrukningen.
Som Nature uttrycker det:
"Beslutsfattare som prioriterar kostnadseffektivitet kan föredra bagging, medan de som fokuserar på att maximera prestanda kan finna boosting mer fördelaktigt."
"Beslutsfattare som prioriterar kostnadseffektivitet kan föredra bagging, medan de som fokuserar på att maximera prestanda kan finna boosting mer fördelaktigt."
Dessutom måste man överväga risken för överanpassning. Boosting kan ibland anpassa sig till brus snarare än verkliga mönster när fler modeller läggs till. Bagging, däremot, har en mer stabil prestanda som ofta förbättras tills den når en platå. Därför är bagging ofta bättre lämpad för finansiella data som innehåller mycket brus.
Beslutstabell: När man ska använda respektive metod
Nedan finns en tabell som sammanfattar när du bör använda bagging eller boosting, beroende på olika scenarier.
| Scenario | Rekommenderad metod | Anledning |
|---|---|---|
| Brusiga/volatila marknadsdata | Bagging | Robust mot brus; minskar variansen genom medelvärdesberäkning |
| Svaga modeller med hög bias | Boosting | Förbättrar noggrannheten genom sekventiell felkorrigering |
| Begränsad tid/resurser | Bagging | Lägre beräkningskostnad och stöd för parallell träning |
| Precisa trendprognoser | Boosting | Ger högre noggrannhet på stabil och lågbrusig data |
| Instabilt modellval | Bagging | Effektiv för att hantera modell- och parameterosäkerhet |
| Höga extremvärden | Bagging | Mindre känslig för avvikande datapunkter |
Denna tabell kan fungera som en snabbguide när du står inför valet mellan dessa två kraftfulla metoder.
Slutsats
Valet mellan boosting och bagging handlar i grunden om att förstå din data och dina mål. Bagging är ett utmärkt val för volatila finansmarknader där brus och extremvärden är vanliga. Genom att kombinera flera oberoende modeller och ta medelvärdet minskar metoden variansen, vilket ger stabil prestanda och minskar risken för överanpassning. Boosting, å andra sidan, lämpar sig bättre för renare data och situationer där maximal precision är målet. Dock kräver det noggrann övervakning för att undvika att modellen överanpassar sig till brus snarare än att identifiera verkliga mönster.
En viktig aspekt att ha i åtanke är resurskraven. Vid användning av 200 basmodeller tar boosting ungefär 14 gånger längre tid att köra jämfört med bagging. Detta beror på att boostings beräkningsbehov ökar kvadratiskt, medan bagging skalar linjärt. För traders som arbetar med högfrekvent data eller har begränsade resurser kan denna skillnad vara avgörande.
För finansiella tidsserier med hög volatilitet och mycket brus är bagging ett säkert förstahandsval. Men om du arbetar med stabil data, har möjlighet att investera i beräkningskapacitet och kan lägga tid på att optimera hyperparametrar, kan boosting ge en högre grad av noggrannhet.
Moderna verktyg som LightGBM och histogram-baserade metoder har dessutom gjort boosting mer praktiskt användbart för stora dataset. För att undvika överanpassning, särskilt i finansiella sammanhang där felbedömningar kan bli kostsamma, bör du alltid använda early stopping och validera prestandan på data som modellen inte tränats på.
För mer information om ensemblemetoder och avancerad marknadsanalys, besök gärna Trendtrading.se, där det finns resurser om både ensemblemetoder och djupinlärning för marknadsanalys.
FAQs
Hur avgör jag om min tidsserie är för brusig för boosting?
Boosting fungerar bäst när datan har en tydlig struktur och inte är alltför präglad av brus. Om din tidsserie visar stor variation eller hög osäkerhet, kan det vara ett tecken på att boosting riskerar att överanpassa modellen. Detta innebär att den försöker anpassa sig för mycket till brus snarare än till den underliggande trenden.
I sådana fall kan bagging vara ett bättre val. Bagging, till skillnad från boosting, är ofta mer motståndskraftigt mot brus eftersom det bygger flera oberoende modeller och kombinerar deras resultat för att minska påverkan från slumpmässiga avvikelser i datan.
För att avgöra vilken metod som passar bäst, undersök din tidsserie noga. Analysera variansen och identifiera om det finns mönster som sticker ut eller om datan verkar slumpmässig. Om brusnivån är hög, kan bagging ge mer tillförlitliga resultat.
Vilka hyperparametrar är viktigast för att undvika överanpassning i boosting?
De viktigaste hyperparametrarna för att undvika överanpassning i boosting handlar om att hålla modellens komplexitet under kontroll och finjustera inlärningshastigheten. Genom att använda regularisering och implementera tidiga stoppmetoder kan du effektivt förhindra att modellen blir för anpassad till träningsdatan. Dessa tekniker hjälper till att balansera modellens prestanda mellan tränings- och testdata, vilket är avgörande för att uppnå god generalisering.
När är en hybrid av bagging och boosting bättre än att välja en av dem?
Hybridmetoder som kombinerar egenskaper från både bagging och boosting kan vara ett smart val när man vill dra nytta av båda teknikers styrkor. Dessa metoder kan förbättra både noggrannheten och stabiliteten i en modell, vilket gör dem särskilt användbara för mer krävande uppgifter som komplexa tidsserieprognoser. Genom att integrera flera ensembletekniker i ett gemensamt ramverk kan man optimera modellens förmåga att göra träffsäkra förutsägelser.
