

LSTM för volatilitet: Hur det fungerar
LSTM-nätverk (Long Short-Term Memory) används för att förutsäga prisvolatilitet på finansmarknader genom att analysera historiska mönster i tidsseriedata. Till skillnad från äldre modeller som GARCH och ARIMA kan LSTM hantera komplexa och icke-linjära samband, vilket gör dem mer effektiva i att förutse marknadsrörelser. Här är några nyckelpunkter:
- LSTM-struktur: Består av glömskeport, inmatningsport och utmatningsport för att hantera långsiktiga beroenden i data.
- Volatilitet och riskhantering: Banker och investerare använder LSTM för att optimera portföljer och förutsäga risk under marknadsnedgångar.
- Dataförberedelse: Sliding window-teknik och normalisering av data förbättrar modellens prestanda.
- Prestanda: LSTM-modeller presterar bättre än GARCH och ARIMA, särskilt under perioder med hög volatilitet.
LSTM-modeller har visat sig framgångsrika på marknader som Stockholmsbörsen och kryptovalutor, där de förbättrar avkastning och minskar risk. Deras förmåga att analysera historiska data och anpassa sig till marknadsförändringar gör dem till ett oumbärligt verktyg inom modern finansiell analys.
The Quant’s Guide to Volatility: From GARCH to Deep Learning LSTMs & Volatility Arbitrage
sbb-itb-e2221a1
Hur LSTM-modeller fungerar för volatilitetsprognos
LSTM-modeller (Long Short-Term Memory) är särskilt användbara för att förutspå volatilitet, tack vare deras förmåga att komma ihåg och analysera tidigare mönster. Processen börjar med att förbereda och strukturera data noggrant, följt av optimerad träning för att förbättra modellens noggrannhet.
Förberedelse av finansiella tidsseriedata
Innan en LSTM-modell kan börja arbeta krävs att den finansiella datan bearbetas och formateras korrekt. Ett viktigt steg är att normalisera datan med verktyg som MinMaxScaler, vilket skalar värden till intervallet 0–1. För att skapa de temporala mönster som LSTM-modellen behöver används sliding window-tekniken, där exempelvis 216 dagar används som tidsfönster. En studie på S&P 500 visade att denna metod bidrog till en imponerande noggrannhet på 92,46 %.
Feature engineering spelar en avgörande roll i processen. Här handlar det om att välja rätt indata, som historiska priser (öppning, högsta, lägsta, stängning), handelsvolym och tekniska indikatorer som RSI och glidande medelvärden. Ett vanligt tillvägagångssätt är att välja variabler med en korrelation över 0,5 med målvariabeln. Intressant nog har vissa studier visat att enbart prisdata kan ge en högre noggrannhet (96,41 %) jämfört med bredare dataset (92,46 %), vilket visar hur viktigt det är att välja rätt features.
När datan är färdigstrukturerad kan modellen börja tränas för att bättre förstå marknadens dynamik.
Träning av LSTM-modeller
Med den förberedda datan optimeras modellens parametrar för att fånga marknadens beteende så exakt som möjligt. I en studie på Stockholmsbörsens OMX30 använde forskare Bayesian optimization för att hitta optimala parametrar, inklusive en learning rate på 0,0075, en batchstorlek på 6 800 och en dropout rate på 0,06. Dropout används för att förhindra överanpassning genom att slumpmässigt stänga av vissa neuroner under träningen.
| Parameter | Exempelvärde | Syfte |
|---|---|---|
| Optimizer | Adam | Effektiv gradientnedstigning |
| Dolda noder | 3 | Reglerar modellens komplexitet |
| Dropout Rate | 0,06 | Förhindrar överanpassning |
| Träningsperiod | 750 dagar | Ger historiskt sammanhang |
| Output Activation | Sigmoid | Mäter konfidensgrad (0–1) |
För att öka tillförlitligheten används ofta en ensemble av flera LSTM-nätverk. Carmina Fjellström implementerade till exempel 11 separata nätverk med olika viktinitialiseringar för OMX30. Genom att använda ett majoritetsbeslut – där exempelvis 8 av 11 nätverk är överens – skapades mer pålitliga prognoser. För att säkerställa att modellen fortsätter prestera på hög nivå omtränas den regelbundet, vanligtvis var 30:e dag eller var sjätte vecka, så att den kan anpassa sig till förändrade marknadsförhållanden.
LSTM vs traditionella modeller för volatilitetsprognos
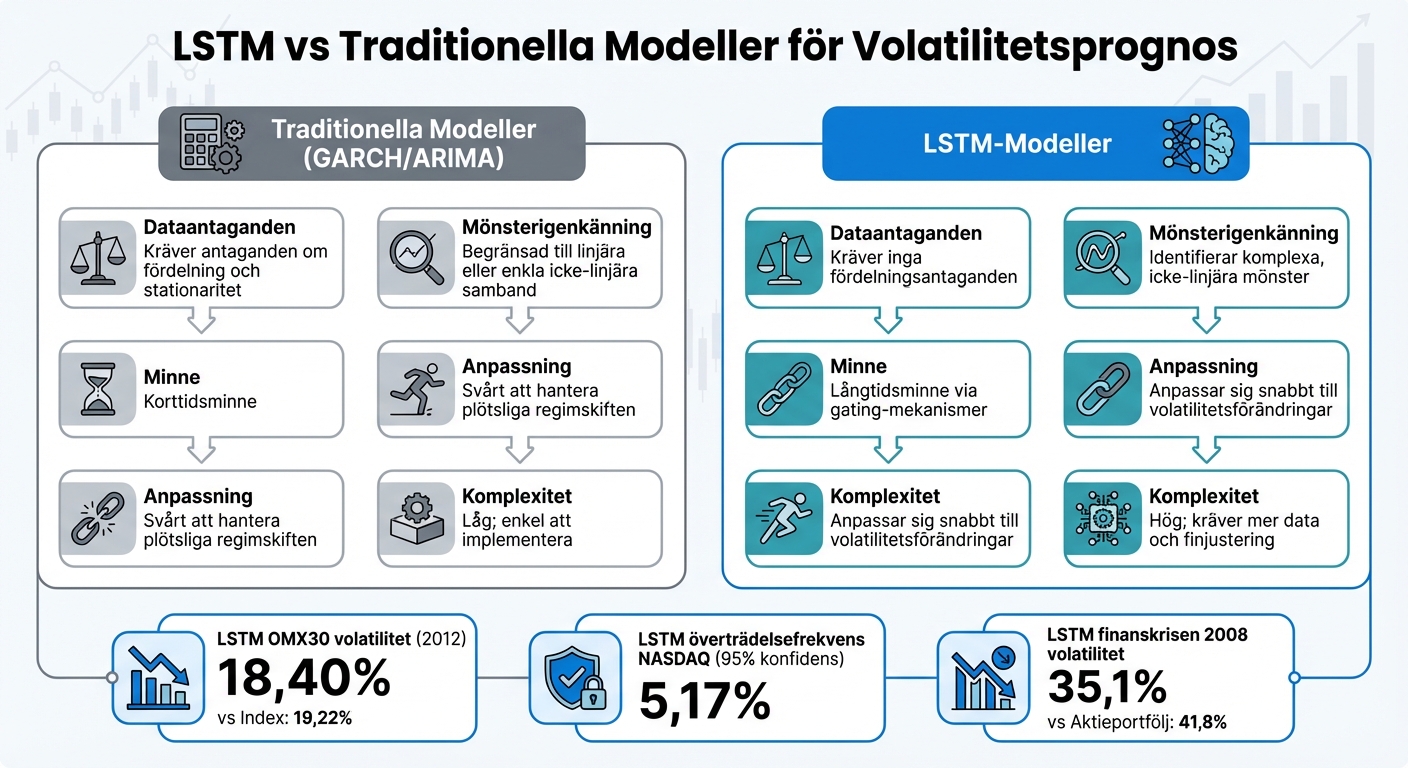
LSTM vs traditionella modeller för volatilitetsprognos – jämförelse
När det handlar om att förutspå marknadsvolatilitet har LSTM-modeller visat sig prestera bättre än traditionella metoder som ARIMA och GARCH, särskilt under perioder av marknadsoro. Skillnaden ligger i deras struktur: medan traditionella modeller är parametriska och förlitar sig på specifika antaganden om datafördelning, är LSTM-modeller icke-parametriska och kan anpassa sig smidigare till komplexa marknadsdata. Låt oss titta närmare på de begränsningar som traditionella modeller har.
Begränsningar hos traditionella modeller
Modeller som GARCH och ARIMA förlitar sig på fasta antaganden om hur data är fördelad och hur marknaden beter sig. Detta gör att de ofta presterar sämre på ny data, särskilt på grund av de icke-linjära, brusiga och icke-stationära egenskaper som kännetecknar finansiella marknader. GARCH-modeller är dessutom begränsade till kortsiktiga samband – till exempel kan en GARCH(1,1)-modell bara hantera ett begränsat antal tidigare observationer.
En studie av NASDAQ visar att LSTM-modeller är betydligt bättre på att identifiera volatilitetskluster än traditionella metoder. Philip Nilsson Sparf och Carl Henrik Rohdin från Göteborgs universitet utvecklade en Quantile LSTM-modell som uppnådde en överträdelsefrekvens på 5,17 % vid 95 % konfidensnivå mellan 1993 och 2023.
"LSTM exhibits a similar performance to GARCH estimators on simulated data, whereas on real market data it is more sensitive towards increasing or decreasing volatility." – Weronika Ormaniec
LSTM-fördelar under perioder med hög volatilitet
När man granskar hur LSTM-modeller hanterar finansiella tidsseriedata blir deras styrkor tydliga, särskilt vid hög volatilitet. Eftersom de är icke-parametriska kräver de inga förutbestämda antaganden om datafördelning. Deras gating-mekanismer gör det möjligt att minnas relevant information över längre tidsperioder och anpassa sig till ny data. Detta är särskilt användbart vid regimskiften eller plötsliga förändringar i marknadsvolatiliteten.
I en studie av S&P 500 mellan 2000 och 2023 visade Natalia Roszyk och Robert Ślepaczuk att hybridmodeller som kombinerar LSTM och GARCH presterade bättre än enbart GARCH-modeller. Genom att inkludera VIX-indexet, ofta kallat "rädslemätaren", kunde modellen fånga marknadens sentiment i realtid och reagera snabbare på förändringar.
| Aspekt | Traditionella modeller (GARCH/ARIMA) | LSTM-modeller |
|---|---|---|
| Dataantaganden | Kräver antaganden om fördelning och stationaritet | Kräver inga fördelningsantaganden |
| Mönsterigenkänning | Begränsad till linjära eller enkla icke-linjära samband | Identifierar komplexa, icke-linjära mönster |
| Minne | Korttidsminne | Långtidsminne via gating-mekanismer |
| Anpassning | Svårt att hantera plötsliga regimskiften | Anpassar sig snabbt till volatilitetsförändringar |
| Komplexitet | Låg; enkel att implementera | Hög; kräver mer data och finjustering |
Dessa skillnader understryker varför LSTM-modeller är bättre lämpade för att hantera komplexa volatilitetsmönster.
Forskning från Carmina Fjellström på Stockholmsbörsens OMX30 visar att en LSTM-baserad portfölj presterade bättre under finanskrisen 2008, med högre kumulativ avkastning och lägre volatilitet (35,1 % mot 41,8 % för en aktieportfölj). Detta antyder att LSTM-modeller även kan ge fördelar på mindre och mindre effektiva marknader.
"The enhanced capability of LSTM and NARX networks to recognize and model long-range dependencies offers a significant advantage, particularly in environments marked by high volatility." – Bucci
Forskningsresultat om LSTM för volatilitetsprognos
Forskning bekräftar att LSTM-modeller är väl lämpade för att hantera utmaningarna med icke-linjära och brusiga finansiella tidsserier. Detta gör dem särskilt användbara i marknader med begränsad effektivitet, där traditionella metoder ofta kommer till korta. Studierna som presenteras här ger en tydlig bild av hur LSTM-modeller presterar i praktiken.
Tillämpningar på svenska finansmarknader
Ett exempel på LSTM-modellernas potential är Carmina Fjellströms studie av OMX30-indexet mellan 2002 och 2020. Hon använde en ensemble av 11 separata LSTM-nätverk för att förutsäga prisrörelser bland indexets olika komponenter. År 2012 presterade LSTM-portföljen bättre genom att uppnå en årlig volatilitet på 18,40 %, jämfört med 19,22 % för hela indexportföljen.
Ett annat framstående exempel är arbetet från Philip Nilsson Sparf och Carl Henrik Rohdin vid Göteborgs universitet. De utvecklade två LSTM-baserade ramverk, Quantile och Parametric, för att uppskatta Value-at-Risk (VaR) vid en 95 % konfidensnivå. I sin analys av NASDAQ mellan 1993 och 2023 visade Quantile LSTM-modellen en överträdelsefrekvens på 5,17 %, medan Parametric LSTM-modellen låg på 5,43 %. Båda modellerna överträffade traditionella metoder som Historical Simulation och Normal Variance-Covariance, särskilt när det gällde att fånga volatilitetskluster.
"The two LSTM based VaR models effectively capture nonlinear market dynamics and volatility clustering, offering a robust framework for VaR estimation in accordance with regulatory backtesting." – Philip Nilsson Sparf & Carl Henrik Rohdin
Prestanda på kryptovalutamarknader
Efter de svenska resultaten är det också intressant att se hur LSTM-modeller presterar på kryptovalutamarknader, där volatiliteten är extremt hög. För kryptovalutor som Bitcoin och Ethereum, där plötsliga och kraftiga prisförändringar är vanliga, har LSTM-nätverk visat sig vara särskilt effektiva. De kan modellera långsiktiga beroenden och hantera de snabba regimskiften som ofta gör att traditionella GARCH-modeller misslyckas. Detta gör LSTM till ett kraftfullt verktyg för att hantera de unika utmaningarna på dessa marknader.
Användning av LSTM i automatiserade trendhandelsstrategier
Med en pålitlig prognosmodell för volatilitet kan LSTM-modeller användas för att skapa dynamiska, automatiserade handelsstrategier som reagerar i realtid på marknadsförändringar. Tack vare LSTM:s förmåga att identifiera mönster i volatiliteten blir dessa strategier mer flexibla och anpassningsbara.
Volatilitetsbaserade handelsstrategier
LSTM-modeller möjliggör automatiserade strategier som justeras efter marknadens volatilitet i realtid. Genom att förutsäga om en tillgångs avkastning kommer att överstiga eller understiga medianen kan portföljinnehav optimeras dagligen. Detta gör det möjligt att dynamiskt justera positionsstorlekar och stop-loss-nivåer baserat på den förväntade volatiliteten.
Tidigare forskning med ensemblemetoder har visat att majoritetsbeslut kan filtrera bort svaga signaler och förbättra resultaten. Till exempel har sådana metoder visat sig minska årlig volatilitet och förbättra Sharpe-kvoter vid praktisk tillämpning.
På Trendtrading.se kan LSTM-modeller integreras via API:er för att leverera volatilitetsprognoser som styr automatiska handelsmotorer. Detta öppnar upp för strategier som inriktar sig på aktier med hög volatilitet eller kortsiktiga reverseringsmönster, vilket kan aktivera trendföljande eller mean-reversion-strategier.
Realtidsanpassning och automation
Modern handel kräver kontinuerlig anpassning, och här spelar LSTM en avgörande roll. Genom att använda en glidande fönster-metod kan modeller tränas om regelbundet för att hålla jämna steg med förändrade marknadsförhållanden. Bayesiansk optimering används för att automatisera inställningen av hyperparametrar som antal dolda lager, dropout-nivåer och batchstorlekar.
I en studie av S&P 500-aktier mellan 1992 och 2015 visade LSTM-modeller en genomsnittlig daglig avkastning på 0,46 % och en Sharpe-kvot på 5,8 före transaktionskostnader. Trots att prediktionsnoggrannheten ofta ligger nära 50 % på grund av marknadsbrus, överträffar LSTM-modeller enklare metoder som Random Forest genom att använda återkopplingsslingor för att behålla historisk information.
"LSTM networks, with their capacity to model extended temporal relationships, present an encouraging alternative [to GARCH models]." – IEEE Xplore
För att undvika överanpassning i livehandel bör batch-normalisering och dropout-lager implementeras. Dessutom kan riskjusterade mått som Sortino-kvoten användas för att utvärdera hur väl strategin hanterar nedåtriktad risk, vilket ger en mer nyanserad bild än enbart Sharpe-kvoten.
Slutsats
LSTM-modeller har visat sig överträffa traditionella metoder som GARCH och ARIMA när det gäller att förutse marknadsvolatilitet. Deras förmåga att hantera både icke-linjära mönster och långsiktiga beroenden i finansiella tidsserier gör dem särskilt användbara. Ett exempel är forskaren Carmina Fjellströms studie från januari 2022, där en ensemble av LSTM-nätverk på Stockholm OMX30 genererade både högre kumulativ avkastning och bättre genomsnittlig daglig avkastning jämfört med en standardportfölj. Dessutom visade LSTM-portföljen lägre volatilitet, vilket resulterade i förbättrade risk-avkastningsförhållanden. Denna typ av resultat formar grunden för moderna handelsstrategier.
LSTM-modeller har också visat sig effektiva för riktningsklassificering, där de kan avgöra om volatilitet eller prisrörelser överstiger ett medianvärde. En studie från Lunds universitet understryker detta med följande insikt:
"när en handelsstrategi implementeras baserad på förändringens riktning, överträffar ett djupt LSTM-nätverk kraftigt tidsseriemodellen".
Dessutom har LaSTM-modeller, som arbetar med flera tidsskalor, visat sig prestera ungefär 20 % bättre än traditionella rough volatility-modeller när det gäller att förutsäga genomsnittlig intradagsvolatilitet.
Plattformar som Trendtrading.se gör det enklare för handlare att dra nytta av dessa avancerade metoder. De erbjuder utbildning om hur man använder djupinlärningsmodeller som LSTM, CNN och RNN för att förutsäga marknadstrender och volatilitet. Genom att integrera LSTM-modeller via API:er kan handlare få tillgång till realtidsprognoser som styr automatiserade handelsmotorer. Detta möjliggör strategier som snabbt kan anpassa sig till förändrade marknadsförhållanden. Ensemblemetoder minskar variabiliteten och förbättrar modellens generalisering, medan tekniker som dropout-lager och batch-normalisering hjälper till att undvika överanpassning.
Dessa resultat visar tydligt att LSTM-modeller spelar en central roll i dagens automatiserade handelsstrategier.
FAQs
Vad är skillnaden mellan LSTM-modeller och traditionella modeller som GARCH och ARIMA?
LSTM-modeller skiljer sig från traditionella metoder som GARCH och ARIMA genom sin förmåga att hantera både komplexa och icke-linjära mönster i tidsseriedata. ARIMA är en linjär modell som bygger på historiska data för att förutsäga framtida värden. Den fungerar särskilt bra för att modellera trender och säsongsvariationer. GARCH, å andra sidan, är utformad för att modellera volatilitet och tar hänsyn till att variansen i en tidsserie kan förändras över tid.
Det som gör LSTM-nätverk unika är deras förmåga att fånga långsiktiga beroenden i data. De kan hantera både linjära och icke-linjära mönster, vilket gör dem idealiska för att analysera marknadsvolatilitet och andra komplexa beteenden som traditionella modeller ofta missar. Medan ARIMA och GARCH är effektiva inom sina respektive områden, erbjuder LSTM en mer mångsidig lösning för att tolka och analysera komplexa tidsseriedata.
Hur förbereder man data för LSTM-modeller inom finans?
Att förbereda data för LSTM-modeller kräver en noggrann och strukturerad process. Här är några viktiga steg att följa:
- Samla och rensa data
Börja med att samla in relevant tidsseriedata, som aktiekurser eller avkastning. Se till att datan är av hög kvalitet genom att åtgärda saknade värden och hantera extrema avvikelser som kan påverka analysen. - Skalning av data
Eftersom LSTM-modeller är känsliga för olika skalor, bör du normalisera eller standardisera datan. Ett vanligt tillvägagångssätt är att använda min-max-skalning för att säkerställa att alla värden ligger inom ett jämförbart intervall. - Skapa användbara funktioner
För att förbättra modellens förmåga att identifiera mönster kan du skapa funktioner som glidande medelvärden, volatilitet eller andra indikatorer som speglar marknadens dynamik. - Dela upp datasetet
Dela upp datan i tränings-, validerings- och testuppsättningar. Bevara den tidsmässiga ordningen i datasetet för att undvika dataläckage och säkerställa att framtida värden inte påverkar modellträningen. - Förbered sekvenser
Omvandla datan till fasta sekvenser där varje sekvens innehåller ett specifikt antal tidigare observationer. Dessa används sedan som indata för att förutsäga framtida värden.
Genom att följa dessa steg kan du skapa en solid grund för att använda LSTM-modeller för att analysera och förutsäga tidsseriedata, som exempelvis marknadsvolatilitet. Detta förberedelsearbete är avgörande för att modellen ska prestera effektivt.
Hur används LSTM-modeller för att förbättra automatiserad handel?
LSTM-modeller (Long Short-Term Memory) spelar en viktig roll inom automatiserad handel genom att analysera och förutse marknadens volatilitet samt identifiera riktningen på prisrörelser. Deras styrka ligger i förmågan att hantera tidsseriedata, vilket gör dem särskilt användbara för att upptäcka komplexa mönster och långsiktiga beroenden – något som är avgörande för att förstå marknadens dynamik.
När LSTM-modeller används i automatiserade handelssystem kan de generera köpsignaler baserat på förväntade marknadsrörelser och anpassa strategier i realtid. Dessutom kan de beräkna riskmått som Value at Risk (VaR), vilket förbättrar riskhanteringen och hjälper till att optimera positioneringen. Med dessa funktioner blir LSTM-modeller ett kraftfullt verktyg för att utveckla mer exakta och datadrivna handelsstrategier.
