

Så förbättrar GANs syntetisk data för trendhandel
GANs (Generative Adversarial Networks) hjälper traders att simulera marknadsscenarier som inte finns i historiska data. Med hjälp av två nätverk – en generator och en diskriminator – skapas syntetisk data som efterliknar verkliga marknadsmönster. Detta löser problemet med begränsad historisk data och möjliggör bättre stresstester och robustare strategier.
Viktig information:
- Problem: Historisk data saknar ofta extrema händelser och är begränsad i volym.
- Lösning med GANs: Skapar realistiska pristrajektorier som kan användas för att träna AI-modeller.
- Fördelar: Minskad överanpassning, fler scenarier för stresstester, och bättre prestanda på nya marknadsförhållanden.
- Utmaningar: Mode collapse, höga beräkningskrav och behov av noggrann validering.
GANs är särskilt användbara för trendhandel, där de förbättrar modellernas förmåga att hantera marknadsfluktuationer och sällsynta händelser.
Hur GANs skapar syntetisk marknadsdata
Den adversariella träningsprocessen
GANs (Generative Adversarial Networks) bygger på en dynamik där två neurala nätverk tävlar mot varandra. Generatorn skapar syntetiska prissekvenser medan Discriminatorn försöker avgöra om dessa är äkta eller falska. Under träningen justeras båda nätverken genom backpropagation: Generatorn förbättras i att lura Discriminatorn, och Discriminatorn blir bättre på att skilja syntetisk data från verklig.
Allt börjar med att Generatorn tar emot slumpmässig input från ett latent rum – ofta en normalfördelning – som omvandlas till syntetiska pristrajektorier. För att hantera finansiella tidsserier använder avancerade modeller som TimeGAN ett inbäddat rum och en övervakad förlustfunktion. Detta hjälper modellen att fånga samband över tid, inte bara enskilda datapunkters fördelning. Det ideala målet är att nå en Nash-jämvikt, där Generatorn producerar data så realistisk att Discriminatorn inte kan skilja den från verklig data mer än slumpmässigt – en träffsäkerhet på 50 %.
"The generative network’s training objective is to increase the error rate of the discriminative network." – David E. Allen, Shelton Peiris och Leonard Mushunje
"Den generativa nätverkets träningsmål är att öka felfrekvensen hos det diskriminerande nätverket." – David E. Allen, Shelton Peiris och Leonard Mushunje [7]
"Det generativa nätverkets träningsmål är att öka felfrekvensen hos det diskriminerande nätverket." – David E. Allen, Shelton Peiris och Leonard Mushunje [7]
Den här träningsdynamiken är kärnan i hur GANs lär sig och återspeglar historiska marknadsmönster.
Lärande från historisk marknadsdata
När träningsprocessen är på plats, fokuserar GANs på att analysera och återskapa mönster från historisk marknadsdata. Här handlar det om att förstå både tvärsnittsfördelningar (samband mellan olika tillgångar vid en given tidpunkt) och temporala dynamiker (hur mönster utvecklas över tid). TimeGAN är en modell som kombinerar oövervakad adversariell förlust med övervakad förlust, vilket gör det möjligt att fånga övergångar mellan tidssteg på ett sätt som speglar verklig data. För att undvika problem som träningsinstabilitet och "mode collapse" används ofta Wasserstein GANs med Gradient Penalty (WGAN-GP). Denna metod justerar förlustfunktionen för att bättre matcha syntetisk data med verklig marknadsdata.
"The goal is to reward the model for learning the distribution over transitions from one point in time to the next present in the historical data." – Stefan Jansen
"Målet är att belöna modellen för att lära sig fördelningen över övergångar från en tidpunkt till nästa som finns i de historiska datan." – Stefan Jansen [4]
Till exempel har experiment med WGAN-GP på Bitcoin-data visat att de syntetiska tidsserierna kan vara visuellt identiska med verkliga data, även om djupare analys kan avslöja skillnader i numeriska fördelningar. Den här förmågan att skapa realistiska marknadsmönster är avgörande för att lösa problemet med begränsad tillgång till marknadsdata.
Mätning av syntetisk datakvalitet
För att säkerställa att den syntetiska datan håller hög kvalitet används tre huvudsakliga metoder:
- Mångfald (Diversity): Här används tekniker som PCA och t-SNE för att kontrollera att de syntetiska datapunkternas fördelning liknar den verkliga datans.
- Trovärdighet (Fidelity): En tidsserieklassificerare, exempelvis ett 2-lagers LSTM, tränas för att skilja mellan verklig och syntetisk data. Om klassificeraren har svårt att göra detta indikerar det hög kvalitet.
- Användbarhet (Usefulness): Testet "Train on Synthetic, Test on Real" (TSTR) används för att se om en modell tränad på syntetisk data kan prestera väl på verklig data.
Förutom dessa metoder valideras syntetisk data genom dess förmåga att återspegla stiliserade fakta om finansiella marknader, som tunga svansar i avkastningsfördelningar, volatilitetskluster och hävstångseffekten. Ekonometriska tester som kointegration och regressionsanalys används också för att jämföra den syntetiska datan med verklig prisdynamik. Denna noggranna kvalitetskontroll gör det möjligt att använda syntetisk data för att utveckla effektiva strategier för marknadstrender.
sbb-itb-e2221a1
Generering av syntetiska finansiella tidsserier med GANs – Casper Hogenboom
Fördelar med GANs för trendhandelsstrategier
Traditionell vs GAN-förstärkt data för trendhandel – jämförelse
Utökning av träningsdataset
GANs gör det möjligt att skapa syntetiska pristrajektorier som speglar historiska marknadsfördelningar, vilket drastiskt ökar mängden tillgänglig data. Det innebär att träningsdataset kan utökas från några få år till decennier – eller till och med tusentals år – av syntetisk marknadsdata. Med hjälp av TimeGAN kan temporala mönster fångas, vilket säkerställer att de syntetiska sekvenserna efterliknar marknadens autoregressiva beteende. Detta öppnar dörrar för att träna avancerade modeller som LSTM och Transformer på en datamängd som annars hade varit omöjlig att samla in från verkliga marknader.
Den här tekniken är särskilt användbar för trendhandel, där modeller kan tränas på scenarier som är underrepresenterade i historiska data, som perioder med extrem volatilitet eller specifika breakout-mönster. Den extra datamängden gör det också lättare för modeller att prestera väl i olika marknadsförhållanden.
Bättre modellgeneralisering
Med en större och mer varierad träningspool kan neurala nätverk identifiera mönster som fungerar över olika marknadsregimer. Ett exempel är experiment med NASDAQ-100-data där WGAN + Transformer presterade med en genomsnittlig maximal avvikelse (mMD) på 0,038 och en KL-divergens på 0,078, vilket visar hög likhet med verkliga marknadsfördelningar.
"By improving the size and diversity of the training datasets, this method improves the generalization of the model." – Yifan Guo
“Genom att förbättra storleken och mångfalden i träningsdatamängderna förbättrar denna metod modellens generaliseringsförmåga." – Yifan Guo [2]
Denna förbättrade generalisering är avgörande för trendhandlare, eftersom deras strategier behöver fungera i olika typer av marknadsmiljöer – från tjur- och björnmarknader till sidledes rörelser.
Testning av strategier med syntetiska scenarion
Med GAN-genererad data kan handlare utföra omfattande stresstester av sina strategier. Genom att simulera hela Limit Order Books (LOB) kan algoritmer testas i miljöer som speglar realtidsmarknader. Detta är särskilt relevant för högfrekvenshandel och adaptiva algoritmer som måste reagera snabbt på förändrade marknadsförhållanden.
Studier inom råvaru- och valutamarknader visar att användning av syntetisk data för att generera prediktiva signaler kan förbättra vinster i handelssimulationer. GANs förmåga att skapa flera möjliga utvecklingsvägar gör det möjligt för handlare att utveckla strategier som är motståndskraftiga mot olika marknadsfluktuationer. Dessutom minskar denna syntetiska data risken för överanpassning i modellerna.
Minskning av överanpassning i AI-modeller
GANs hjälper till att motverka överanpassning genom att introducera variation i de syntetiska pristrajektorierna, samtidigt som de bevarar viktiga statistiska egenskaper.
Ett exempel är forskaren Sam Dannels, som i februari 2023 använde DoppelGANger-arkitekturen för att skapa syntetiska tidsserier för statsobligationsräntor och recessioner. Resultaten visade att modeller tränade på dessa syntetiska "katastrof"-scenarier hade bättre kortsiktig prognosförmåga och kunde förutsäga framtida recessioner mer effektivt än modeller som endast använt historiska data. TimeGAN-modeller har också visat sig prestera bättre i "Predictive Scores", vilket innebär att de ger mer tillförlitliga resultat i nya marknadsmiljöer. Detta är avgörande för att hålla trendhandelsstrategier robusta.
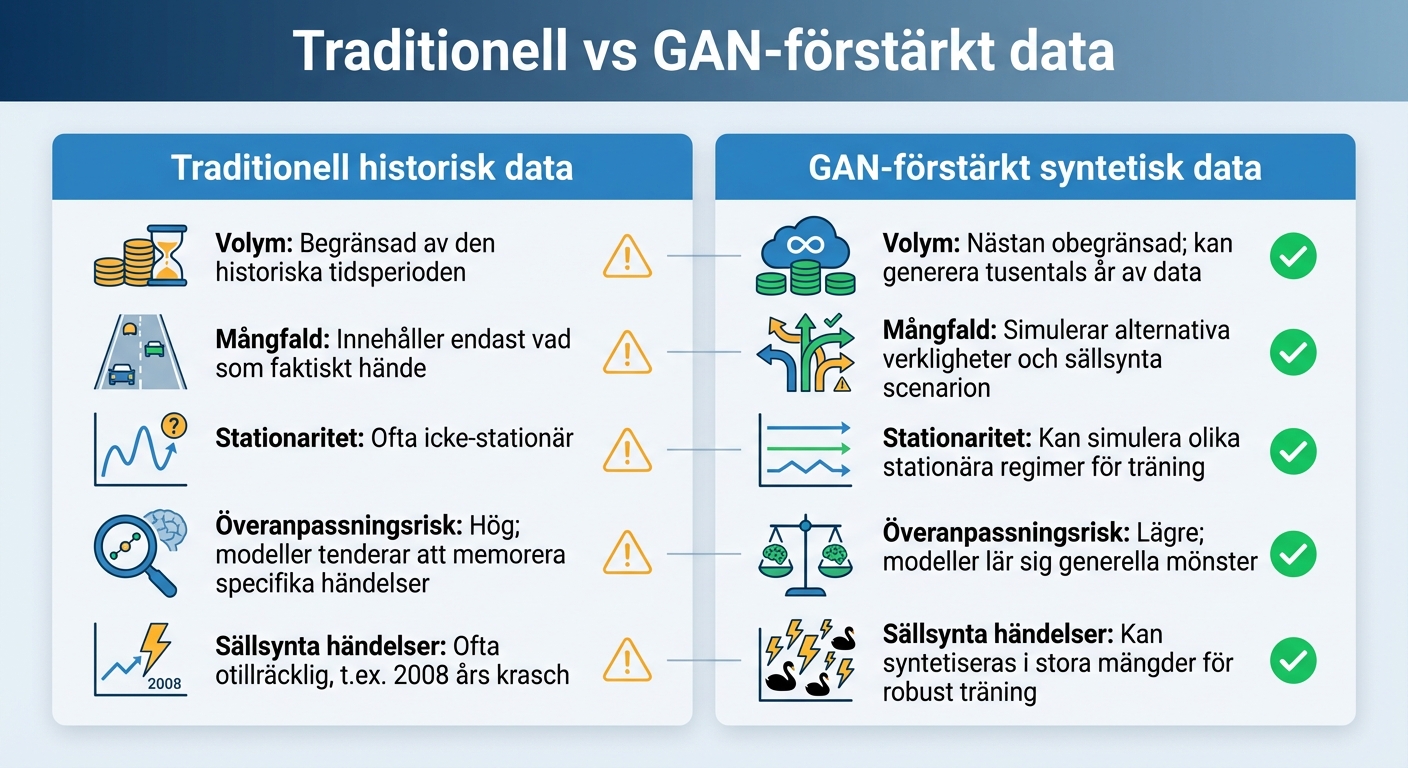
Jämförelse: Traditionell vs GAN-förstärkt data
| Egenskap | Traditionell historisk data | GAN-förstärkt syntetisk data |
|---|---|---|
| Volym | Begränsad av den historiska tidsperioden | Nästan obegränsad; kan generera tusentals år av data |
| Mångfald | Innehåller endast vad som faktiskt hände | Simulerar alternativa verkligheter och sällsynta scenarion |
| Stationaritet | Ofta icke-stationär | Kan simulera olika stationära regimer för träning |
| Överanpassningsrisk | Hög; modeller tenderar att memorera specifika händelser | Lägre; modeller lär sig generella mönster |
| Sällsynta händelser | Ofta otillräcklig, t.ex. 2008 års krasch | Kan syntetiseras i stora mängder för robust träning |
Utmaningar och begränsningar
Trots att GAN-teknologin erbjuder spännande möjligheter, finns det flera utmaningar som kräver uppmärksamhet.
Mode collapse och begränsad datamångfald
Ett av de största problemen med GANs är mode collapse. Det innebär att generatorn skapar en begränsad variation av data, vilket gör att viktiga marknadsegenskaper kan gå förlorade. Detta är särskilt bekymmersamt inom trendhandel, där modeller måste kunna hantera sällsynta extrema händelser som marknadskrascher eller plötsliga prisutbrott.
Ett exempel är backtester på Shanghai Composite Index (2004–2024), där standard-GANs genererade orealistiska resultat: en årlig avkastning på 2 467,24% och volatilitet på 991,83%, jämfört med verkliga siffror på 33,10% respektive 15,20%. Dessutom visade maximal drawdown för dessa modeller extrema värden mellan 109,87% och 148,11%, medan verklig data endast uppvisade 9,50%. Aleksander Törnqvist från Göteborgs universitet noterade att även WGAN-GP, som ofta presterade bättre, misslyckades med att fånga viktiga egenskaper som hög kurtosis och feta svansar i den verkliga fördelningen.
Ett återkommande problem är att syntetisk data inte bara behöver se realistisk ut, utan också bete sig som verklig data i olika handelsstrategier. Traditionella GANs har svårt att fånga "stylized facts", som kurtosis, feta svansar och hävstångseffekten – den negativa korrelationen mellan tidigare avkastning och framtida volatilitet.
Höga beräkningskrav
Att träna avancerade GANs för finansiella tidsserier kräver enorma resurser. Ett exempel är utvecklingen av Stylized Facts Alignment GAN (SFAG) i januari 2026, där forskare använde en NVIDIA A100 GPU med 80 GB minne för att köra 50 000 iterationer. För mindre företag är sådan teknologisk kapacitet ofta utom räckhåll.
Med en sekvenslängd på 2 520 och batchstorlek på 24 tog det många iterationer att uppnå konvergens i "stylized facts". För företag som vill använda modellerna över flera tillgångsklasser, som valuta, råvaror och räntor, kan kostnaderna snabbt bli ohanterliga. Dessutom är standard-GANs ofta instabila under träning, vilket kräver mer avancerade arkitekturer som WGAN-GP för att säkerställa stabilitet.
Validerings- och tillförlitlighetsproblem
Att säkerställa att syntetisk data är statistiskt korrekt är en stor utmaning. Visuell inspektion räcker inte för att garantera att datan håller strukturell integritet – modeller kan verka trovärdiga men ändå missa viktiga egenskaper. I en studie från juli 2023 använde forskarna David E. Allen, Shelton Peiris och Leonard Mushunje Wasserstein GANs för att generera data för S&P 500 och FTSE 100. Genom kointegrationstester och Value at Risk (VaR)-beräkningar visade de att syntetiska serier kunde fånga långvariga minnen och feta svansar, som kännetecknar verkliga finansiella tidsserier.
En viktig del i valideringen är handelsbacktester. Standard-GANs visade ett orimligt tail index-gap på 0,2615, vilket indikerar en bristande förmåga att korrekt uppskatta extrema marknadshändelser. Mer avancerade modeller, som SFAG, lyckades reducera detta gap till 0,0146 genom att optimera tail-index.
Regulatoriska och etiska överväganden
Utöver tekniska utmaningar finns också etiska och juridiska risker. För att följa dataskyddsregler som GDPR måste forskare använda tester som presence- och attribute disclosure för att säkerställa att syntetisk data inte kan användas för att identifiera individer i ursprungsdataset. Ett exempel på risk är länkningsattacker, där angripare kan återidentifiera individer genom att kombinera avidentifierad data med andra källor. Forskare har exempelvis lyckats länka sjukhusdata till DNA-register med hjälp av programvara som REID.
"The re-identification of individuals in publicly available datasets can lead to the exposure of their sensitive health information… Consequently, concerned researchers must find alternative methods of protecting sensitive health data to minimize the risk of re-identification." – Eoin Brophy, Zhengwei Wang, Qi She, och Tomás Ward
"Återidentifiering av individer i offentligt tillgängliga dataset kan leda till exponering av deras känsliga hälsoinformation… Följaktligen måste berörda forskare hitta alternativa metoder för att skydda känslig hälsodata för att minimera risken för återidentifiering." – Eoin Brophy, Zhengwei Wang, Qi She och Tomás Ward [14]
För att minska dessa risker bör syntetisk data genereras med differential privacy. Dessutom rekommenderas three-sample-tester på tränings-, test- och syntetisk data för att säkerställa att GAN-modellen inte har överanpassat till träningsdata. Detta är avgörande för att undvika integritetsrisker och säkerställa att den genererade datan är både säker och användbar.
Tillämpningar inom automatiserad trendhandel
Automatiserad trendhandel har länge brottats med utmaningen att historisk data ofta är begränsad. Men genom att använda syntetisk marknadsdata skapas nya möjligheter. Detta gör det möjligt att träna AI-modeller på tusentals potentiella scenarier istället för att enbart förlita sig på historiska data.
Användning av GAN-genererad data med AI-modeller
AI-modeller som LSTM, CNN och RNN kräver omfattande datamängder för att prestera väl. Här kommer generativa adversarial networks (GANs) in i bilden. De kan skapa syntetisk data som inte bara speglar marknadens egenskaper utan också tidsmässiga samband. Ett exempel är TimeGAN, som integrerar tidsmässiga övergångar i syntetisk data och därmed kompletterar strategiska tillämpningar.
I en studie med 579 tillgångar visade conditional GANs (cGANs) sig vara särskilt effektiva för att kalibrera och kombinera strategier. Forskare som Adriano Koshiyama, Nick Firoozye och Philip Treleaven noterade att cGANs presterade bättre än traditionella metoder i situationer där standardtekniker misslyckades med att generera alpha.
"cGANs are a suitable alternative for strategies calibration and combination, providing outperformance when the traditional techniques fail to generate any alpha." – Adriano Koshiyama, Nick Firoozye och Philip Treleaven
"cGANs är ett lämpligt alternativ för kalibrering och kombination av strategier, och ger överprestanda när de traditionella teknikerna misslyckas med att generera någon alpha." – Adriano Koshiyama, Nick Firoozye och Philip Treleaven [1]
Kvaliteten på denna syntetiska data mäts genom tre nyckelområden: Diversity (hur väl den matchar verklig datafördelning), Fidelity (hur trovärdig den är) och Usefulness (hur väl den presterar i prediktiva uppgifter). TimeGAN har visat sig överträffa andra alternativ på dessa punkter. Detta öppnar dörren för mer flexibla strategier, vilket leder oss till hur reinforcement learning kan dra nytta av dessa data.
Träning av adaptiva och reinforcement learning-algoritmer
Med hjälp av GAN-genererad data kan reinforcement learning-agenter utforska marknadsscenarier som inte finns i historiska dataset. Processen börjar med att definiera metadata, som aktie-ID:n och annan relevant information, för att skapa en bredare träningsuppsättning.
Genom att kombinera historiska prissignaler med syntetiska sekvenser minskar risken för överanpassning. Daniel Carvajal-Patiño och Raul Ramos-Pollán fann att denna metod förbättrade prediktiv modellering med upp till 4,63 %. I studier av råvaru- och valutamarknader, som XAU/USD och EUR/USD, visade GAN-förstärkta strategier konsekvent bättre resultat än modeller som enbart tränats på historisk data.
"Synthetic data obtained this way replicates the distribution properties of real historical data, leads to better performance, and enables thorough validation of predictive models for price signals." – Daniel Carvajal-Patiño och Raul Ramos-Pollán
"Syntetiska data som erhålls på detta sätt återskapar fördelningsegenskaperna hos verkliga historiska data, leder till bättre prestanda och möjliggör grundlig validering av prediktiva modeller för prissignaler." – Daniel Carvajal-Patiño och Raul Ramos-Pollán
Metoden "Train on Synthetic, Test on Real" (TSTR) används för att kontinuerligt uppdatera RL-agenter genom att kombinera verklig och syntetisk data.
Förbättrad momentum- och breakout-detektion
GAN-genererad data har också visat sig vara användbar för att upptäcka förändringar i marknadstrender, som momentum och breakouts. Eftersom GANs lär sig den gemensamma fördelningen av data (p(y, X)) får de en djupare förståelse för marknadens dynamik jämfört med traditionella modeller.
Stefan Jansen förklarar att målet är att belöna modeller som lär sig övergångar mellan olika tidpunkter i historisk data. Detta är särskilt viktigt för att identifiera prisrörelser som kännetecknar breakouts. GANs kan också generera fler exempel på dessa ovanliga händelser, vilket förbättrar modellernas träning och kortsiktiga prognostisering av exempelvis Treasury yields. Genom att skapa alternativa prisbanor som statistiskt speglar historisk data kan handelsmodeller tränas på ett bredare spektrum av scenarier.
Högfrekvenshandel-tillämpningar
GAN-genererad data har även en viktig roll inom högfrekvenshandel. Här används GANs för att skapa marknadssimulatorer som tar hänsyn till prisrörelsernas autoregressiva natur och tidsmässiga korrelationer. Detta gör det möjligt att testa modeller mot ett stort antal simulerade scenarier istället för att förlita sig på begränsad historisk data.
För att undvika problem med extrema datapunkter genereras istället avkastningssignaler. Kontextvariabler, som företagssektor, hjälper dessutom till att koppla specifika volatilitetsmönster till olika tillgångstyper.
José Carlos Gonzáles Tanaka betonar att syntetisk data av hög kvalitet kan skapa flera banor av samma datafördelning, vilket gör det möjligt att optimera strategier för exempelvis stop-loss och take-profit-nivåer. Dessutom möjliggör syntetisk data testning av vägberoende strategier, vilket ytterligare förbättrar modellernas prestanda.
Trendtrading.se erbjuder resurser och övningar för att lära sig använda avancerade algoritmer som LSTM, CNN och RNN för att förutsäga trender och bygga automatiserade handelssystem som kan dra nytta av GAN-genererad data.
Slutsats
GANs adresserar en av finansbranschens stora utmaningar – den begränsade tillgången till historisk marknadsdata – genom att skapa oändliga variationer av trovärdiga marknadstrajektorier. Detta gör det möjligt att träna AI-modeller på scenarier som ännu inte inträffat.
Syntetisk data har flera klara fördelar. Den minskar risken för överanpassning genom att möjliggöra validering mot varierande dataset och kan tillhandahållas upp till tio gånger snabbare än med traditionella metoder. Dessutom bryter den inte mot integritetslagar som GDPR, vilket gör det enklare att dela data och samarbeta. För mindre aktörer, som ofta saknar resurser att köpa dyr marknadsdata, är detta särskilt användbart.
Trots dess potential finns det utmaningar. Problem som mode collapse och höga beräkningskostnader kan begränsa modellernas förmåga att exakt simulera extrema marknadshändelser. Exempelvis har modeller som WGAN-GP svårt att fullt ut fånga fenomen som feta svansar och extrema avvikelser. Dessutom kräver mer avancerade arkitekturer betydligt längre beräkningstid än enklare GAN-modeller.
Framtiden ser dock lovande ut. Nya arkitekturer som Market-GAN kan göra det möjligt för användare att generera data anpassad till specifika marknadssituationer, som volatilitet eller sektorspecifika trender. Dessutom förväntas kombinationen av GANs, reinforcement learning och adaptiva algoritmer bli en central del av automatiserad trendhandel. Detta kan leda till bättre simulering av finansiella mönster som långt minne, volatilitetskluster och hävstångseffekter.
Med dessa framsteg blir det avgörande att säkerställa hög datakvalitet. För dem som arbetar med trendhandel är det viktigt att använda flera utvärderingsmått, som Diversity, Fidelity och Usefulness, för att säkerställa att syntetisk data verkligen förbättrar modellernas resultat. Trendtrading.se erbjuder resurser för att hjälpa praktiker att implementera dessa avancerade metoder. Genom att kombinera GAN-genererad data med noggranna valideringsprocesser kan trendhandelsstrategier bli mer motståndskraftiga mot marknadens svängningar och bättre förberedda för framtida utmaningar.
FAQs
Hur kan jag veta att GAN-data är tillräckligt realistisk för backtester?
För att säkerställa att data skapad av GAN (Generative Adversarial Networks) är tillräckligt realistisk för backtesting, är det viktigt att den återspeglar nyckelstatistiska egenskaper från verkliga marknadsdata. Det handlar bland annat om att bevara de fyra första statistiska momenten: medelvärde, standardavvikelse, skevhet och kurtosis. Dessutom måste den stokastiska beroendestrukturen, både mellan olika dimensioner och över tid, efterliknas för att resultaten ska vara tillförlitliga.
När är TimeGAN bättre än WGAN-GP för trendhandel?
TimeGAN är ofta ett bättre val än WGAN-GP för trendhandel, särskilt när det är avgörande att bevara tidsmässiga och sekventiella mönster i finansiella tidsseriedata. Den är utformad för att fånga de temporala dynamikerna, vilket gör att den genererade marknadsdatan blir både mer trovärdig och konsekvent.
Hur minskar jag risken för mode collapse i finansiella tidsserier?
För att minska risken för mode collapse vid användning av GANs för finansiella tidsserier kan du dra nytta av mer sofistikerade arkitekturer som Wasserstein GANs (WGANs) med gradientstabilisering. Dessa metoder förbättrar träningsprocessens stabilitet genom att adressera problem som instabila gradienter och obalanserade datafördelningar, vilket i sin tur minskar risken för att GAN-modellen fastnar i att generera begränsade eller repetitiva mönster.
