

Signalspel i trading: Begränsningar i praktiken
Signalspel används inom trading för att minska informationsskillnader mellan aktörer. En trovärdig signal måste vara tillräckligt kostsam för att endast aktörer med hög kvalitet ska kunna använda den. Men i praktiken finns flera hinder, som marknadsbuller, falska signaler och begränsningar hos AI-modeller. Dessa faktorer gör det svårt att skilja verkliga signaler från slumpmässiga variationer. Dessutom kan datakvalitet och snabbhet i beräkningar påverka signalernas effektivitet negativt.
Nyckelpunkter:
- Signalens trovärdighet: Kostnaden måste avskräcka lågkvalitativa aktörer från att imitera.
- Utmaningar: Marknadsbuller, datafel och AI:s begränsningar skapar osäkerhet.
- Riskhantering: Diversifiera signaler, använd stop-loss och testa strategier med Monte Carlo-simuleringar.
Trots dessa utmaningar kan traders förbättra sina strategier genom att kombinera olika signaltyper och använda avancerade riskhanteringsverktyg.
Teoretiska grunder för signalspel
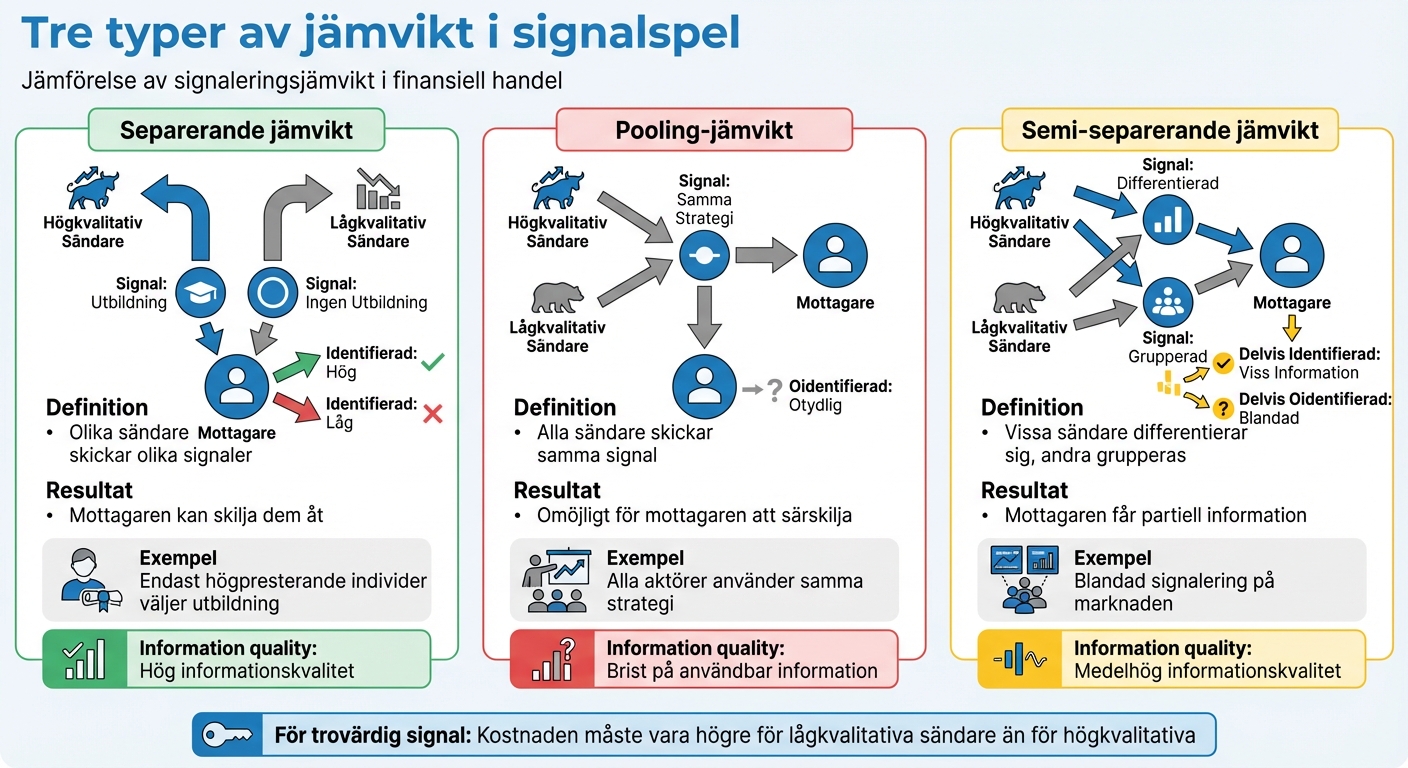
Tre typer av jämvikt i signalspel: Separerande, Pooling och Semi-separerande
För att förstå hur signalspel fungerar i praktiken behöver vi först titta på dess teoretiska ramverk. I centrum för detta står Perfect Bayesian Equilibrium (PBE), en förfining av Bayesiansk Nash-jämvikt som används i dynamiska spel med ofullständig information. PBE kombinerar två viktiga principer: att aktörer väljer strategier som maximerar deras nytta (sekventiell rationalitet) och att deras uppfattningar uppdateras med hjälp av Bayes regel (konsistens).
Ekonom Michael Spence beskrev detta fenomen på ett tydligt sätt:
"If people cannot communicate their ability directly, they will acquire education even if it does not increase productivity, to demonstrate ability".
"Om människor inte kan kommunicera sin förmåga direkt, kommer de att skaffa sig utbildning för att demonstrera denna förmåga, även om utbildningen inte ökar produktiviteten" [3].
Perfect Bayesian Equilibrium och jämviktstyper
Signalspel kan resultera i tre olika typer av jämvikt:
- Separerande jämvikt: Här skickar olika sändare olika signaler, vilket gör det möjligt för mottagaren att skilja dem åt. I Spences utbildningsmodell innebär detta att endast högpresterande individer väljer att utbilda sig, eftersom utbildningen fungerar som en signal om deras förmåga.
- Pooling-jämvikt: Alla sändare skickar samma signal, vilket gör det omöjligt för mottagaren att särskilja dem. Detta leder till en brist på användbar information.
- Semi-separerande jämvikt: Vissa sändare differentierar sig, medan andra grupperas ihop. Detta ger mottagaren partiell information.
För att en signal ska vara trovärdig inom en finansiell PBE måste den dessutom innebära en kostnad. Det ska vara dyrare för en lågkvalitativ sändare att skicka signalen än för en högkvalitativ, vilket gör signalen mer pålitlig.
Med dessa jämviktstyper i åtanke kan vi nu utforska hur asymmetrisk information påverkar finansmarknader.
Asymmetrisk information på finansmarknader
På finansmarknader uppstår asymmetrisk information när sändaren försöker övertyga mottagaren om att de representerar en "önskvärd typ". För att lyckas måste signalen vara tillräckligt kostsam för att avskräcka oönskade typer från att imitera. Investopedia beskriver detta så här:
"Signaling theory is the belief that information on a company’s financial health is not available to all parties in a market at the same time".
"Signaleringsteori är övertygelsen om att information om ett företags finansiella hälsa inte är tillgänglig för alla parter på en marknad samtidigt" [5].
Asymmetrisk information kan leda till problem som adverse selection och moral hazard. Adverse selection innebär att felaktiga val görs på grund av bristande information, medan moral hazard uppstår när individer tar onödiga risker eftersom någon annan bär kostnaderna.
För att minska osäkerheten används olika typer av signaler på moderna marknader, exempelvis:
- Investeringar i forskning och utveckling.
- Prissättningsstrategier.
- Offentliga meddelanden.
Ett konkret exempel är insidertransaktioner, där företagsledare skickar starka signaler om företagets framtidsutsikter genom sina egna investeringar.
Även om dessa teoretiska grunder visar hur signaler bör fungera under ideala förhållanden, är verkligheten ofta mer komplex. Traders möter stora utmaningar när de försöker tolka signaler i realtid, vilket vi ska undersöka i nästa avsnitt om de praktiska utmaningarna i signalidentifiering.
sbb-itb-e2221a1
Praktiska begränsningar i signalidentifiering
Även om teorin kring signalidentifiering kan verka lovande, möter traders i praktiken flera hinder. Marknadsbuller, volatilitet och begränsningar hos AI skapar en komplex verklighet där signalernas effektivitet ofta urholkas.
Buller och marknadsvolatilitet
Marknadsbuller är ett stort problem. Det kan skapa falska samband, så kallade spurious regressions, där tekniska signaler verkar vara betydelsefulla men i själva verket bara reflekterar slumpmässiga prisrörelser. Som Financial Markets and Portfolio Management uttrycker det:
"Technical trading signals can be considered as noise."
"Tekniska handelssignaler kan betraktas som brus." [6]
Volatilitet gör det ännu mer komplext. En studie på Opening Range Breakout-strategin visade att avkastningen kan variera kraftigt beroende på marknadens volatilitet. Till exempel kan skillnaden i avkastning per dag vara 200 räntepunkter för råolja och 150 räntepunkter för S&P 500-terminer. Det betyder att samma signal kan ge helt olika resultat beroende på marknadens tillstånd.
Ett annat problem är data snooping bias. När traders testar tusentals olika strategier eller parameterkombinationer ökar risken att hitta regler som verkar framgångsrika enbart på grund av slumpen. En omfattande studie av 6 406 tekniska strategier över 41 marknader visade att deras prestanda utanför testperioden ofta var obetydlig eller till och med negativ. En Monte Carlo-simulering av OMXS30 visade dessutom att sannolikheten att hitta en signifikant regel av ren slump är så låg som 0,12 %.
Tillsammans med dessa utmaningar kämpar även AI-metoder med att skilja verkliga mönster från slumpmässiga variationer.
AI-utmaningar i signaldetektering
AI-modeller som LSTM-nätverk och RNN har potential, men de möter också hinder när det gäller att identifiera signaler i dynamiska marknader. Oscar Jansson från Lunds universitet betonar:
"Quality of data, data availability, and complexity of AI and finance has severely limited AI adoption in trading."
"Kvaliteten på data, tillgången till data och komplexiteten inom både AI och finans har kraftigt begränsat införandet av AI inom trading." [10]
Michael Harris från Price Action Lab belyser en annan svårighet:
"The statistical properties of some genuine trading strategies are often indistinguishable from those of random trading strategies."
"De statistiska egenskaperna hos vissa genuint fungerande handelsstrategier är ofta omöjliga att skilja från egenskaperna hos slumpmässiga handelsstrategier." [8]
Trots sin sofistikering misslyckas AI-modeller ofta med att skilja verkliga signaler från slumpmässiga variationer. Problemet blir särskilt tydligt när man arbetar med multi-period returns och långsiktiga glidande medelvärden, som tenderar att bli icke-stationära. Detta leder till att t-statistik och lutningsestimatorer i prediktiva modeller divergerar, vilket resulterar i falska signaler.
AI-system står också inför en svår balansgång mellan hastighet och tillförlitlighet. De måste anpassa sig till föränderliga marknadsförhållanden utan att missa viktiga trender eller fastna i så kallade "whipsaws", där positioner öppnas och stängs i snabb följd. Detta gör signalidentifiering till en utmaning även för de mest avancerade systemen.
Datakvalitet och beräkningsmässiga begränsningar
När det gäller signalanalys och trading möter traders ofta två stora hinder: dålig datakvalitet och komplexiteten i beräkningarna. Dessa faktorer kan snabbt förvandla en lovande strategi till en förlust, särskilt i realtidshandel där varje millisekund kan vara avgörande.
Hur datakvalitet påverkar signalanalys
Att förstå buller och marknadens volatilitet är en sak, men datakvalitet spelar också en avgörande roll i trading. Nimasha Attanayake, kvantitativ utvecklare, beskriver detta på ett enkelt men slagkraftigt sätt:
"Bad data leads to bad models. Bad models lead to bad trades. And bad trades? Well, they lose money, often quietly, but sometimes catastrophically."
"Dålig data leder till dåliga modeller. Dåliga modeller leder till dåliga affärer. Och dåliga affärer? De förlorar pengar, ofta tyst, men ibland katastrofalt." [13]
Siffrorna är svindlande. Dålig datakvalitet kostar den amerikanska ekonomin hela 3,1 biljoner dollar årligen. För enskilda företag innebär detta i genomsnitt 12,9 miljoner dollar i förluster varje år på grund av felaktig data. Dessutom spenderar traders upp till 80 % av sin tid på att rensa och förbereda data, vilket lämnar väldigt lite tid för själva analysen.
Utmaningen blir ännu större när avvecklingsprocesserna snabbas upp. Införandet av T+1-avveckling har minskat tiden för att rätta till datafel från 26 timmar till endast 2 timmar. Resultatet? Felfrekvensen för icke-CNS-avvecklingar ökade från 2,01 % till 2,92 %. Pamela Rana, Senior Product Owner på Genesis Global, belyser problemet:
"If you don’t get the data right, you’re not settling on time. The buy-side doesn’t care if it’s data quality or system issues; the middle office is still on the hook."
"Om du inte får ordning på datan kommer du inte att kunna reglera affärerna i tid. Köpsidan bryr sig inte om det beror på datakvalitet eller systemfel; ’middle office’ bär fortfarande ansvaret." [15]
Felformaterade tidsstämplar kan också förvränga signaler, vilket leder till felaktiga tolkningar av marknadsstrukturen. För AI-modeller blir konsekvenserna ännu mer kritiska. Orena eller partiska data kan orsaka "overfitting", där strategier som ser lovande ut i tester misslyckas helt när de tillämpas på riktiga marknader.
Efter att ha granskat datakvalitetens påverkan är det dags att titta närmare på den tekniska utmaningen med beräkningskomplexitet i realtid.
Beräkningskomplexitet i realtidshandel
För att lyckas med realtidshandel krävs både ren data och hög beräkningskapacitet. Även avancerade AI-modeller kan ha svårt att särskilja signaler från brus om infrastrukturen inte håller måttet. Jeff Sekinger från Wealth Strategies beskriver vikten av snabbhet:
"Even milliseconds of delay can mean the difference between a profitable trade and a missed opportunity."
"Till och med millisekunders fördröjning kan innebära skillnaden mellan en lönsam affär och ett missat tillfälle." [17]
Moderna AI-system kan genomföra analyser och affärer på under 100 mikrosekunder. Denna hastighet är dock beroende av kraftfulla servrar och optimerad infrastruktur. Maskininlärningsbaserade handelssystem har en träffsäkerhet på 75 %, vilket är högre än de 60–65 % som traditionella metoder når. Men dessa system måste samtidigt hantera risker som stop-loss på 3,5 % per affär och portfölj-drawdowns på upp till 30 %.
Utmaningarna ökar ytterligare när algoritmer måste navigera komplexa lösningsrum för att hitta optimala lösningar i realtid. Detta kräver ofta avancerade tekniker som evolutionära algoritmer eller djup förstärkningsinlärning. Dessutom kan algoritmer som presterar bra i tester misslyckas i livehandel på grund av faktorer som ökade spreadar, likviditetsproblem och slippage.
För att hantera dessa utmaningar behöver traders investera i högpresterande servrar, arbeta med pålitliga mäklare och implementera dynamiska strategier som anpassar positionsstorleken efter marknadens volatilitet. Dubbla stop-loss-skydd, både på affärs- och portföljnivå, kan också minska riskerna. Denna tekniska komplexitet visar hur viktigt det är att ständigt justera och förbättra realtidsstrategier.
Riskhantering och begränsningsstrategier
När traders står inför utmaningar som signalfel och praktiska hinder i signalidentifiering, är det avgörande att skydda kapitalet med genomtänkta riskhanteringsstrategier.
Erfarna traders håller sig ofta till en regel att aldrig riskera mer än 1 % av sitt kapital på en enskild handel och håller marginalanvändningen mellan 20 % och 30 %. Dessa riktlinjer är resultatet av många års erfarenhet och är utformade för att minimera riskerna.
Anpassning till signalfel
Ett sätt att hantera signalfel är att kombinera olika typer av signaler, som snabba och långsamma, för att sprida riskerna. Erik Martin Hansén, analytiker på Neuroquant, förklarar detta tydligt:
"De bästa resultaten under 2024 kom från strategier som använde en mix av snabba och långsamma signaler. Detta återspeglar en grundläggande princip för systematisk investering: att undvika att satsa allt på en enda parameter."
Under 2024 visade sig långsamma signaler vara mer effektiva än snabba i marknader med korta trender och snabba vändningar. För att minska falska signaler kan traders använda filter, som att kräva att priset stänger utanför en formation i två dagar i rad eller att det rör sig minst dubbelt så mycket som Average True Range (ATR) innan signalen anses bekräftad.
Ett annat användbart verktyg är dynamisk positionsstorlek, där positionsstorleken anpassas efter marknadens volatilitet. En populär metod är "2 %-regeln", som innebär att aldrig riskera mer än 2 % av det totala kapitalet på en enskild affär. Vid hög volatilitet minskar positionsstorleken automatiskt, vilket skyddar kontot från plötsliga och stora förluster.
Utöver dessa tekniker behövs ytterligare verktyg för att validera signalernas pålitlighet och säkerställa deras effektivitet.
Avancerade riskhanteringsverktyg
I en marknad fylld av brus och osäkra signaler kan avancerade riskhanteringsverktyg göra stor skillnad.
Monte Carlo-simuleringar är ett exempel på hur traders kan testa signalernas motståndskraft mot slumpmässiga scenarier. En studie från Lunds universitet 2020, ledd av Erik Nordin, analyserade 33 års historisk data från OMXS30-indexet med 1 000 Monte Carlo-simuleringar. Studien visade att ingen enskild teknisk regel presterade bättre än en enkel köp-och-håll-strategi när datautvinningsbias togs i beaktande. Detta betonar vikten av att testa signaler mot slumpmässiga förhållanden.
Bootstrapping-metoder är ett annat sätt att utvärdera framgångsfrekvensen hos mekaniska handelsregler. Dessa metoder hjälper till att avgöra om reglerna faktiskt presterar bättre än slumpmässiga resultat. Dessutom bör traders vara vaksamma på riskfyllt beteende hos signalleverantörer på sociala handelsplattformar. Forskning visar att vissa underpresterande leverantörer ökar sin exponering mot extremt volatila tillgångar för att försöka återhämta sig, vilket kan utsätta följare för stora risker.
Genom att kombinera dessa strategier – från diversifierade signaler och volatilitetsjusterade stopp till Monte Carlo-simuleringar och analyser av incitament – kan traders bygga robusta system som hanterar begränsningar och klarar även de mest krävande marknadsförhållandena.
Slutsats och viktiga insikter
Sammanfattning av begränsningar och lösningar
Signalbaserade strategier står inför flera utmaningar i praktiken. Falska signaler och marknadsbrus kan leda till oväntade prisvändningar, där traders tvingas lämna positioner precis innan marknaden vänder. Dessutom är manipulativa signalmetoder som spoofing och quote layering förbjudna enligt lag, vilket kan resultera i kontoavstängningar eller rättsliga åtgärder. En studie från Lunds universitet visar att chanserna att hitta en verkligt lönsam teknisk regel är så låga som 0,12 %.
Ett effektivt sätt att hantera dessa risker är att diversifiera signalhastigheter. Genom att kombinera snabba signaler, som 50-dagars breakouts, med långsammare signaler, som 200-dagars glidande medelvärden, minskar risken att hamna på fel sida av trenden. Kaminski och Zhao lyfter fram detta i sin forskning:
"The best results in 2024 came from strategies that used a mix of fast and slow signals".
"De bästa resultaten under 2024 kom från strategier som använde en blandning av snabba och långsamma signaler" [1].
Med dessa utmaningar i åtanke riktas nu fokus mot framtidens signalanalys och dess möjligheter.
Framtida perspektiv inom signalanalys
När vi reflekterar över dagens begränsningar blir det tydligt att framtidens signalanalys kommer att präglas av ökad AI-användning och striktare reglering. Redan idag kan AI-system uppnå vinst/förlust-kvoter över 80 % genom att analysera globala makrodata och nyhetsflöden. Samtidigt kvarstår problemen med så kallade "black box"-system, där tillsynsmyndigheter som FCA och SEC nu kräver att företag kan förklara hur deras AI-modeller fungerar och säkerställer mänsklig övervakning.
Dessa begränsningar driver behovet av en ny strategi för både metodik och AI-användning. Traders måste förbereda sig för en framtid där marknadens förutsägbarhet gradvis minskar. En omfattande studie av 41 marknader visar att tekniska regler har förlorat sin förutsägbara kraft på de flesta utvecklade marknader efter 2002. Dessutom kan transaktionskostnader på bara 20 baspunkter eliminera fördelarna med många tekniska regler. För att lyckas framöver bör AI ses som ett stödverktyg snarare än en ersättning för mänskligt omdöme, och strategier bör testas noggrant under extrema marknadsförhållanden för att säkerställa deras robusthet.
FAQs
Hur vet jag att en signal är trovärdig?
För att avgöra hur pålitlig en signal är, bör du titta på dess historiska resultat, dess konsekvens över tid och om den baseras på solida matematiska eller statistiska metoder. Det är också klokt att använda flera olika signaler för att bekräfta dess trovärdighet, eftersom beslut aldrig bör baseras på en enda signal.
Hur undviker jag falska signaler och data snooping?
För att undvika falska signaler och fenomenet data snooping är det viktigt att minska risken för att modeller överanpassas till historiska data. Ett sätt att göra detta är att använda statistiska metoder som kan justera för data snooping-bias, som exempelvis bootstrap-tekniker och verktyg som White’s Reality Check.
Ett annat viktigt steg är att validera strategier på out-of-sample-data, alltså data som inte användes vid modellens utveckling. Dessutom bör robusta tester inkluderas, där hänsyn tas till faktorer som transaktionskostnader och marknadens volatilitet. Detta hjälper till att säkerställa att de identifierade signalerna faktiskt är tillförlitliga och inte bara en produkt av slumpmässiga mönster i datan.
När hjälper AI och när stjälper den i trading?
AI kan spela en stor roll inom trading genom att förbättra både hastigheten och kvaliteten på beslutsfattandet. Med hjälp av avancerade teknologier som deep learning kan AI analysera enorma mängder data på kort tid, identifiera komplexa mönster och reagera snabbt på marknadsförändringar. Detta gör det möjligt att förutspå trender och fatta mer informerade beslut baserat på historiska data och realtidsinformation.
Men det finns också risker. AI kan ibland generera falska signaler eller agera på felaktig data, vilket kan leda till oönskade resultat. Dessutom är bristande insyn i hur AI-modeller fattar beslut ett problem, särskilt när det gäller att förstå och förklara deras agerande. Det finns också en risk för att AI-system kan manipuleras, vilket gör det extra viktigt att kombinera AI med mänsklig expertis och en robust strategi för riskhantering.
