

Vanliga problem med Q-Learning i handel
Q-Learning används ofta inom algoritmisk handel för att fatta beslut baserade på marknadsdata. Trots dess potential finns flera utmaningar som kan påverka dess effektivitet, särskilt på volatila marknader som OMXS30. Här är de viktigaste problemen och lösningarna:
- Balans mellan utforskning och exploatering: Svårt att testa nya strategier utan att riskera förluster.
- Högdimensionella tillståndsrum: Marknadsdata är komplex och kräver avancerade metoder som neurala nätverk.
- Konvergens- och stabilitetsproblem: Svårigheter att få konsekventa resultat på grund av marknadens volatilitet.
Lösningar:
- Förbered data noggrant med tekniska indikatorer som RSI och glidande medelvärden.
- Använd dynamiska inlärningshastigheter och övervaka modellens prestanda.
- Kombinera Q-Learning med djupinlärning, som Deep Q-Networks (DQN), för att hantera komplexa tillstånd.
Svenska handlare kan dra nytta av dessa metoder genom att anpassa modellerna till lokala marknadsförhållanden, inklusive transaktionskostnader och marknadslikviditet.
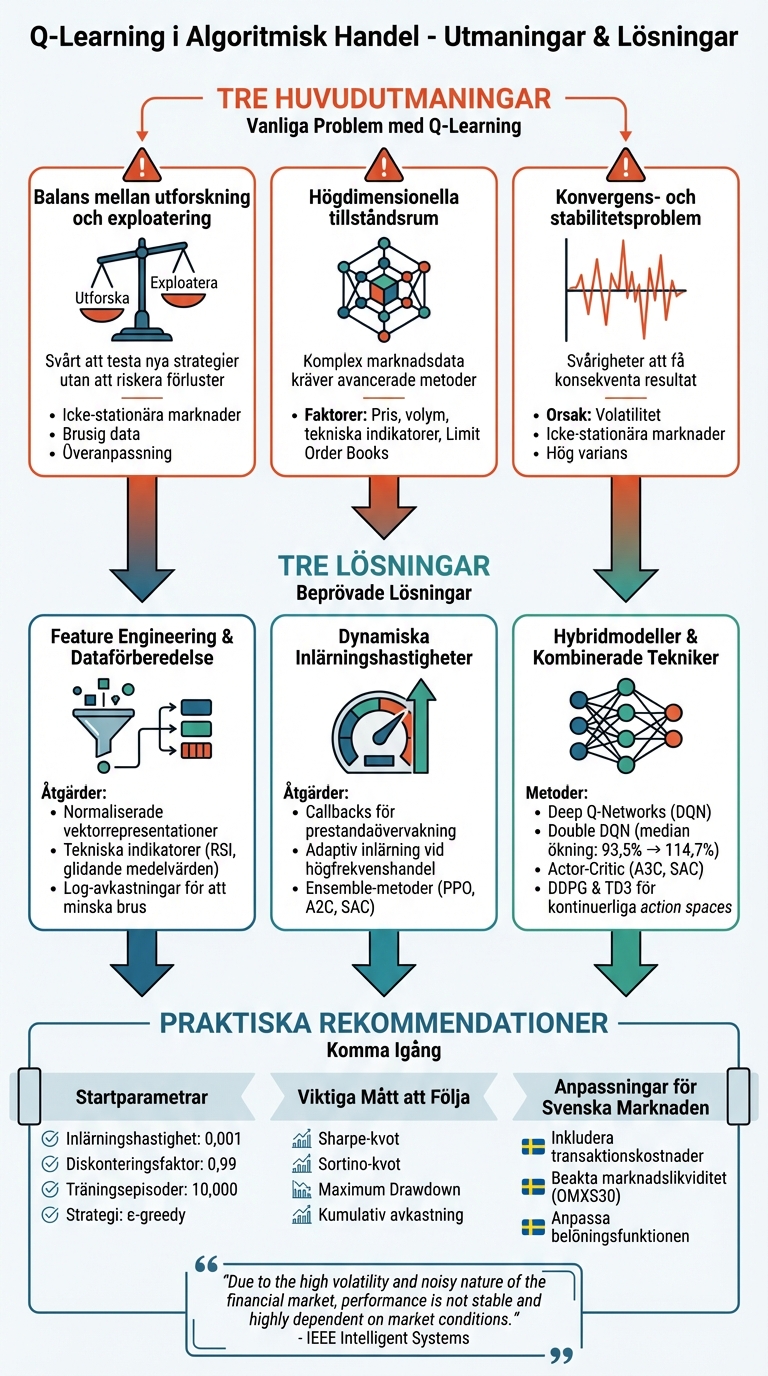
Q-Learning utmaningar och lösningar i algoritmisk handel
Handelsstrategi med förstärkningsinlärning (Reinforcement Learning). DQN: QNetwork, QRNNNetwork
sbb-itb-e2221a1
Vanliga problem med Q-Learning i handel
Q-Learning kan verka lovande för automatiserad handel, men svenska handlare stöter ofta på flera praktiska hinder vid implementering. Dessa utmaningar kan påverka både systemens lönsamhet och stabilitet, särskilt på volatila marknader som OMXS30.
Balans mellan utforskning och exploatering
En av de största svårigheterna med Q-Learning inom handel är att balansera mellan att testa nya strategier och att dra nytta av redan fungerande metoder. I verklig handel innebär utforskning en direkt ekonomisk risk, eftersom den sker med riktiga pengar. Detta kan leda till betydande förluster och stora drawdowns. Dessutom är finansmarknader icke-stationära, vilket innebär att en strategi som fungerar idag kan bli ineffektiv imorgon när marknadsförhållandena förändras. Därför krävs det att man fortsätter att utforska även efter att en strategi verkar vara optimal.
Den här balansgången försvåras ytterligare av den brusiga och volatila marknadsdatan, vilket gör det svårt att avgöra om en framgång beror på en bra strategi eller på slumpmässiga prisrörelser. Det finns även risk för överanpassning till historiska mönster. Fördröjningar mellan beslut och resultat, samt effekten av stora order på marknadspriset, skapar ytterligare utmaningar. Samtidigt bidrar den höga komplexiteten i tillståndsrummen till att göra Q-Learning ännu mer krävande.
Högdimensionella tillståndsrum
I traditionell Q-Learning används en Q-tabell för att hålla reda på värden för varje möjligt tillstånds-åtgärd-par. Men i handelsmiljöer är tillståndsrummen ofta kontinuerliga och högdimensionella, vilket gör tabellbaserade metoder opraktiska. Dessa tillstånd kan inkludera faktorer som pris, volym, tekniska indikatorer och ibland till och med hela snapshots av Limit Order Books. När flera tillgångar och deras korrelationer tas med i beräkningen blir komplexiteten snabbt ohanterlig, vilket försvårar agentens förmåga att konvergera mot en optimal strategi.
Som en lösning på detta använder många handlare funktionsapproximation med neurala nätverk, exempelvis genom Deep Q-Networks, för att kunna generalisera över liknande tillstånd. Men även detta tillvägagångssätt har sina nackdelar, eftersom det kan skapa problem med beräkningseffektivitet, inlärningskonvergens och modellens stabilitet.
Konvergens- och stabilitetsproblem
Problemen med högdimensionella tillståndsrum och balans mellan utforskning och exploatering leder ofta till konvergens- och stabilitetsproblem i Q-Learning-modeller för handel. Den brusiga och volatila naturen hos finansiell data gör det svårt att få konsekventa Q-värden. Eftersom marknader är icke-stationära förändras deras statistiska egenskaper över tid, vilket gör att tidigare inlärda värden snabbt kan bli irrelevanta. Detta kan leda till att modellen divergerar eller beter sig oförutsägbart, särskilt när funktionsapproximation används.
Om policyn uppdateras för ofta kan den dessutom börja oscillera, eftersom action-value-estimaten inte hinner anpassa sig till det aktuella marknadstillståndet. Som IEEE Intelligent Systems uttrycker det:
"Due to the high volatility and noisy nature of the financial market, [traditional] performance is not stable and highly dependent on market conditions."
"På grund av den höga volatiliteten och det brusiga särdraget hos den finansiella marknaden är [traditionell] prestanda inte stabil och i hög grad beroende av marknadsvillkor."
Hög varians i handelsavkastningen gör det också svårt att få exakta estimat för att jämföra olika åtgärder. Detta resulterar ofta i suboptimala eller oregelbundna handelssignaler. För att hantera dessa utmaningar behöver svenska handlare implementera tekniker som stabiliserar träningsprocessen och förbättrar modellens konsistens.
Lösningar på Q-Learning-utmaningar
Att övervinna utmaningarna med Q-Learning kräver genomtänkta lösningar som förbättrar databehandling och ökar modellens stabilitet.
Feature engineering och dataförberedelse
Att förbereda data korrekt är en nyckel för att Q-Learning ska fungera effektivt i handelsmiljöer. Istället för att använda råa prisdata kan du skapa tillstånd som normaliserade vektorrepresentationer av avkastningar över en viss tid – exempelvis de senaste n dagarna – vilket ger en mer konsekvent indata för agenten. Tekniska indikatorer som RSI och glidande medelvärden är särskilt användbara eftersom de kan avslöja viktiga marknadsmönster. Kombinerar du dessa med härledda mätvärden, som log-avkastningar, kan du minska brus och förbättra datans hanterbarhet. Dessutom säkerställer normalisering att variabler som pris och volym ligger på jämförbara skalor. När datan är väl förberedd blir det lättare att optimera inlärningshastigheter för att hantera marknadens förändringar.
Dynamiska justeringar av inlärningshastighet
Marknadens volatilitet kan skapa problem för modellens konvergens, vilket gör det viktigt att följa dess prestanda noggrant. Genom att använda callbacks som övervakar förlustutvecklingen kan du snabbt identifiera om inlärningshastigheten orsakar instabilitet eller om modellen har fastnat. Vid högfrekvenshandel blir adaptiv inlärning särskilt viktig, eftersom marknadsineffektivitet ofta är kortvarig. Strategier bör vara flexibla och kunna anpassa sig efter olika marknadslägen – som tjur-, björn- och konsolideringsfaser – samt hantera volatilitetskluster. Ensemble-metoder, där flera modeller som PPO, A2C och SAC kombineras, kan förbättra stabiliteten genom att medelvärdesberäkna sina beslut. För ännu mer robusthet kan dessa strategier integreras med hybridmodeller.
Hybridmodeller och kombinerade tekniker
För att hantera komplexa tillståndsrum används ofta en kombination av Q-Learning och djupinlärning. Deep Q-Networks (DQN) är särskilt användbara eftersom de utnyttjar neurala nätverk för att extrahera meningsfulla representationer direkt från rådata, som hela Limit Order Books. Double DQN förbättrar stabiliteten genom att separera val från utvärdering, vilket minskar risken för överestimeringsbias. Faktum är att tester visat att medianpoängen ökade från 93,5% till 114,7%. Actor-Critic-modeller, som A3C och SAC, kombinerar värde- och policybaserade metoder för att både föreslå och utvärdera åtgärder. För kontinuerliga action spaces, exempelvis vid portföljfördelning, har metoder som DDPG och TD3 visat sig vara mycket effektiva.
På Trendtrading.se finns omfattande resurser och praktiska övningar som hjälper dig att implementera dessa avancerade reinforcement learning-system. Plattformen täcker även hur hybridmodeller kan kombineras med riskhanteringsverktyg för att bygga stabila och pålitliga handelssystem.
Fallstudier och exempel
Här tittar vi närmare på hur de tidigare nämnda utmaningarna kan påverka resultaten inom praktisk handel genom några konkreta fallstudier.
Exempel: Trendföljning med Q-Learning
I april 2023 utvecklade forskaren Soumyadip Sarkar en DQN-modell för handel med Nifty 50-indexet. Modellen byggde på historisk daglig OHLC-data från perioden 1 januari 2010 till 31 december 2020. Den definierade agentens tillstånd med hjälp av normaliserade avkastningar över ett glidande fönster på n dagar, kompletterat med tekniska indikatorer som RSI och glidande medelvärden. Strategin använde en ε-greedy metod för att balansera mellan att utforska nya möjligheter och att utnyttja befintlig kunskap.
När modellen testades på data från 2020 presterade DQN-algoritmen bättre än både en enkel köp-och-behåll-strategi och en strategi baserad på glidande medelvärden. Förbättringarna syntes i flera viktiga mått, som kumulativ avkastning, Sharpe-kvot och maximal drawdown. Modellen tränades i 10 000 episoder med en inlärningshastighet på 0,001 och en diskonteringsfaktor på 0,99.
"Reinforcement learning has the potential to revolutionize quantitative trading by allowing trading algorithms to learn from experience and adapt to changing market conditions." – Soumyadip Sarkar, Forskare
"Förstärkningsinlärning har potentialen att revolutionera kvantitativ handel genom att tillåta handelsalgoritmer att lära sig av erfarenhet och anpassa sig till föränderliga marknadsvillkor." — Soumyadip Sarkar, Forskare [3]
För svenska handlare som vill tillämpa liknande metoder på OMXS30 är det avgörande att anpassa belöningsfunktionen efter lokala förhållanden, som transaktionskostnader och marknadens likviditet. Plattformar som Trendtrading.se erbjuder resurser och praktiska övningar för att hjälpa dig att bygga reinforcement learning-system som fungerar på den svenska marknaden. Även om resultaten visar på stora möjligheter, bör man vara medveten om de risker som kan uppstå i praktiken.
Lärdomar från Q-Learning-misslyckanden
En av de största riskerna med Q-Learning är överanpassning till historiskt brus. Det innebär att modellen kan "lära sig" slumpmässiga prisrörelser istället för att identifiera mönster som faktiskt är användbara. Små förändringar i träningsdata kan resultera i helt olika policys, och hög volatilitet gör det svårt att skilja meningsfulla signaler från rena slumpfluktuationer.
För att minimera dessa problem är det viktigt att använda riskjusterade mått, som Sharpe-kvoten, Sortino-kvoten och Maximum Drawdown, istället för att bara fokusera på kumulativ avkastning. Det kan också vara klokt att använda en glidande fönstermetod under träningen, så att modellen kan anpassa sig till förändrade marknadsförhållanden. För att öka robustheten i modellen bör träningen dessutom inkludera data från flera olika källor, som prisdata, nyhetssentiment och tekniska indikatorer. Detta skapar en bredare bas för modellen att fatta sina beslut på och minskar risken för överanpassning.
Slutsats
Sammanfattning av huvudpunkter
Q-Learning öppnar upp många möjligheter inom algoritmisk handel, men det finns flera utmaningar att hantera. Att balansera mellan utforskning och exploatering, hantera högdimensionella tillståndsrum och undvika överanpassning i volatila marknader är några av de viktigaste. Genom att använda metoder som feature engineering och dynamiska inlärningshastigheter kan du skapa system som är mer motståndskraftiga mot dessa problem.
En annan kritisk aspekt är att inkludera transaktionskostnader och slippage direkt i belöningsfunktionen. Om detta förbises riskerar modellen att prestera dåligt i verkliga marknader. När du utvärderar dina modeller bör du använda riskjusterade mått som Sharpe-kvoten, Sortino-kvoten och Maximum Drawdown, snarare än att enbart förlita dig på kumulativ avkastning.
Komma igång med Q-Learning
Med denna kunskap kan du börja experimentera. Ett bra första steg är att använda historisk data från en enskild tillgång och tillämpa grundläggande tekniska indikatorer som RSI och glidande medelvärden. Implementera en ε-greedy-strategi med en inlärningshastighet runt 0,001 och en diskonteringsfaktor på 0,99.
För att fördjupa dig erbjuder Trendtrading.se utbildningsresurser och praktiska övningar, i samarbete med Accuindex, som är särskilt anpassade för den svenska marknaden. Plattformen täcker allt från grunderna i Q-Learning till mer avancerade modeller som LSTM och CNN. Dessutom får du tillgång till verktyg för riskhantering, som Value at Risk och Monte Carlo-simuleringar. Genom att kombinera teori med praktiska övningar kan du utveckla handelssystem som inte bara presterar bra i backtesting utan även i verkliga marknadsförhållanden.
FAQs
Hur balanserar jag mellan utforskning och exploatering i Q-Learning inom automatiserad handel?
Att hitta rätt balans mellan utforskning och utnyttjande är en nyckelkomponent för att en Q-Learning-algoritm ska kunna utveckla effektiva handelsstrategier. En populär metod för detta är den så kallade ε-greedy-strategin. Här låter man algoritmen, med en viss sannolikhet (ε), testa nya alternativ istället för att bara välja det som för tillfället verkar vara det bästa. Genom att gradvis minska värdet på ε över tid kan algoritmen först undersöka många olika möjligheter och sedan fokusera på att använda de strategier som visat sig mest framgångsrika.
I mer komplexa sammanhang kan algoritmer som anpassar sig i realtid vara mycket användbara. Dessa algoritmer kan justera sina parametrar baserat på aktuella marknadsförhållanden, som exempelvis förändringar i volatilitet eller trender. Detta gör att de kan lära sig snabbare och bättre balansera mellan att upptäcka nya mönster och att använda redan kända insikter. En annan viktig aspekt är att utforma en genomarbetad belöningsfunktion. En sådan funktion hjälper algoritmen att fokusera på önskade beteenden, vilket minskar behovet av omfattande utforskning och gör inlärningsprocessen mer effektiv.
Hur kan man hantera högdimensionella tillståndsrum inom algoritmisk handel?
Hantering av högdimensionella tillståndsrum kan vara en rejäl utmaning inom algoritmisk handel. Men det finns sätt att tackla detta problem som både minskar komplexiteten och förbättrar prestandan.
Ett effektivt tillvägagångssätt är att använda stochastic Q-learning. Denna metod begränsar optimeringen till en stokastisk delmängd av möjliga handlingar, vilket i sin tur minskar den beräkningsmässiga belastningen. Resultatet? En algoritm som är betydligt lättare att arbeta med.
En annan användbar teknik är att implementera algoritmer som är konceptbaserade. Dessa algoritmer fokuserar på att identifiera och bevara viktiga mönster i de stora mängder data som finns i ett högdimensionellt tillståndsrum. Genom att koncentrera på relevanta data och filtrera bort brus förbättras inlärningseffektiviteten avsevärt.
Båda dessa metoder är särskilt värdefulla i miljöer som präglas av hög volatilitet och komplexitet – precis de förhållanden som ofta råder inom automatiserad handel.
Hur kan jag göra Q-Learning-modeller mer stabila och pålitliga vid handel på volatila marknader?
För att göra Q-Learning-modeller mer stabila och pålitliga på volatila marknader finns det flera användbara strategier. En av de mest effektiva är att använda regularisering i algoritmen. Regularisering hjälper till att minska risken för instabilitet genom att begränsa modellens komplexitet och förhindra att den överanpassar sig till brusiga data. Detta är särskilt viktigt på marknader som präglas av snabba och oförutsägbara förändringar.
En annan viktig strategi är att finjustera inlärningsparametrarna, som exempelvis inlärningshastigheten och diskonteringsfaktorn. Genom att justera dessa parametrar kan modellen bli mindre känslig för plötsliga marknadsrörelser och istället konvergera mer stabilt över tid.
Dessutom kan stabiliteten förbättras genom att använda robusta kontrollmetoder. Dessa metoder integrerar kontrollorienterade justeringar i belöningsfunktionerna, vilket gör modellen bättre förberedd för att hantera osäkerheter och dynamiska förändringar i marknaden. Detta bidrar till att modellen kan navigera mer effektivt i en miljö som präglas av svängningar och oförutsägbarhet.
